
AI가 미생물 유전체를 뒤져 찾아낸 항생제 후보 86만 개
송준호(송쌤)송쌤생명과학입시연구소 대표
2024년 6월 5일, 미국 펜실베이니아대학교(University of Pennsylvania) 세자르 데라푸엔테(César de la Fuente) 교수 연구팀이 학술지 Cell에 흥미로운 논문을 냈어요. 미생물 유전체 87,920개와 토양·바닷물 같은 환경 시료에서 얻은 메타유전체 63,410개를 기계학습 모델로 통째로 훑어서, 항균 펩타이드(antimicrobial peptide) 후보 물질을 863,498개나 찾아낸 연구예요. 이 중 90% 이상이 지금까지 학계에 한 번도 보고된 적 없는 완전히 새로운 서열이었다는 게 더 놀라운 부분이고요. 저는 이 숫자를 처음 봤을 때 "86만 개면 그냥 컴퓨터가 아무거나 다 뽑아낸 거 아닌가" 싶었는데, 실제로 실험까지 이어진 걸 보면 그게 아니더라고요.
항균 펩타이드가 뭐길래
항균 펩타이드는 아미노산 수십 개 정도로 짧게 이어진 펩타이드로, 사람을 포함한 거의 모든 생물이 선천면역(innate immunity)의 일부로 만들어내는 물질이에요. 우리 피부나 점막에도 이런 펩타이드가 있어요. 이 물질들이 흥미로운 이유는 작동 방식에 있는데, 특정 단백질 하나를 정교하게 겨냥하는 대신 세균 세포막 자체를 물리적으로 파괴하는 경우가 많아요. 세균 세포막은 표면 전하나 지질 구성이 사람 세포막과 달라서, 이 펩타이드가 세균 막에만 선택적으로 달라붙어 구멍을 내는 식이죠. 표적이 막 전체의 물리적 구조라서 세균이 유전자 하나만 바꿔서 슬쩍 피해가기가 상대적으로 어렵다는 것도 장점으로 꼽혀요.
왜 하필 '유전체를 뒤진다'는 발상이었을까
전통적인 항생제 후보 발굴은 토양 미생물을 배양해서 하나하나 물질을 뽑아내고 효과를 확인하는, 시간이 많이 드는 작업이었어요. 그런데 게놈 시퀀싱 기술이 워낙 발전하면서 이미 해독된 미생물·환경 유전체 데이터는 어마어마하게 쌓여 있거든요. 데라푸엔테 팀의 아이디어는 이 방대한 데이터를 처음부터 실험으로 확인하는 대신, 기계학습 모델이 먼저 유전체 서열 속에서 항균 펩타이드일 가능성이 높은 패턴을 찾아내게 하고, 그렇게 좁혀진 후보군만 실험실에서 검증하자는 거였어요. 실제로 연구팀은 이렇게 찾아낸 후보 100개를 골라 합성한 다음 병원균에 직접 노출시켰는데, 63개가 최소 1종 이상의 병원균 증식을 완전히 억제했어요. 100개 중 63개면 적중률이 꽤 높은 편이죠.
쌤 한마디 — 여기서 헷갈리지 말아야 할 게, AI가 "새로운 물질을 발명"한 게 아니라는 점이에요. 이 펩타이드 서열들은 이미 미생물의 유전체 안에 자연적으로 존재하던 것들이에요. AI가 한 일은 이미 존재하는 방대한 데이터 속에서 사람이 일일이 찾기 힘든 패턴을 짚어내는 거였고, 그래서 저는 이걸 '발명'보다는 '발굴' 또는 '채굴(mining)'에 가깝다고 설명해요. 실제로 연구팀도 이 방식을 유전체를 뒤진다는 의미로 표현했고요.
왜 지금 이 연구가 중요할까
항생제 내성균은 전 세계적으로 빠르게 늘고 있는데, 정작 새로운 계열의 항생제 개발은 최근 수십 년간 정체돼 있었어요. 제약회사 입장에서 항생제는 단기간 복용하고 끝나는 약이라 만성질환 치료제보다 수익성이 낮다 보니 투자가 줄어든 영향이 커요. 이런 상황에서 이번처럼 후보군 자체를 대규모로, 그것도 짧은 시간에 확보하는 접근은 의미가 있다는 평가를 받아요. 다만 여기서 꼭 짚어야 할 한계도 있는데, 이번에 효과가 확인된 후보들은 아직 세포·동물 실험 초기 단계예요. 사람에게 실제로 쓸 수 있는 약이 되려면 독성이 없는지, 몸속에서 얼마나 안정적으로 작용하는지 같은 안전성·효능 검증을 다시 여러 해에 걸쳐 거쳐야 해요. 그래서 "AI가 항생제를 만들었다"보다는 "AI가 항생제가 될 만한 후보 목록을 크게 넓혀줬다"는 표현이 더 정확해요.
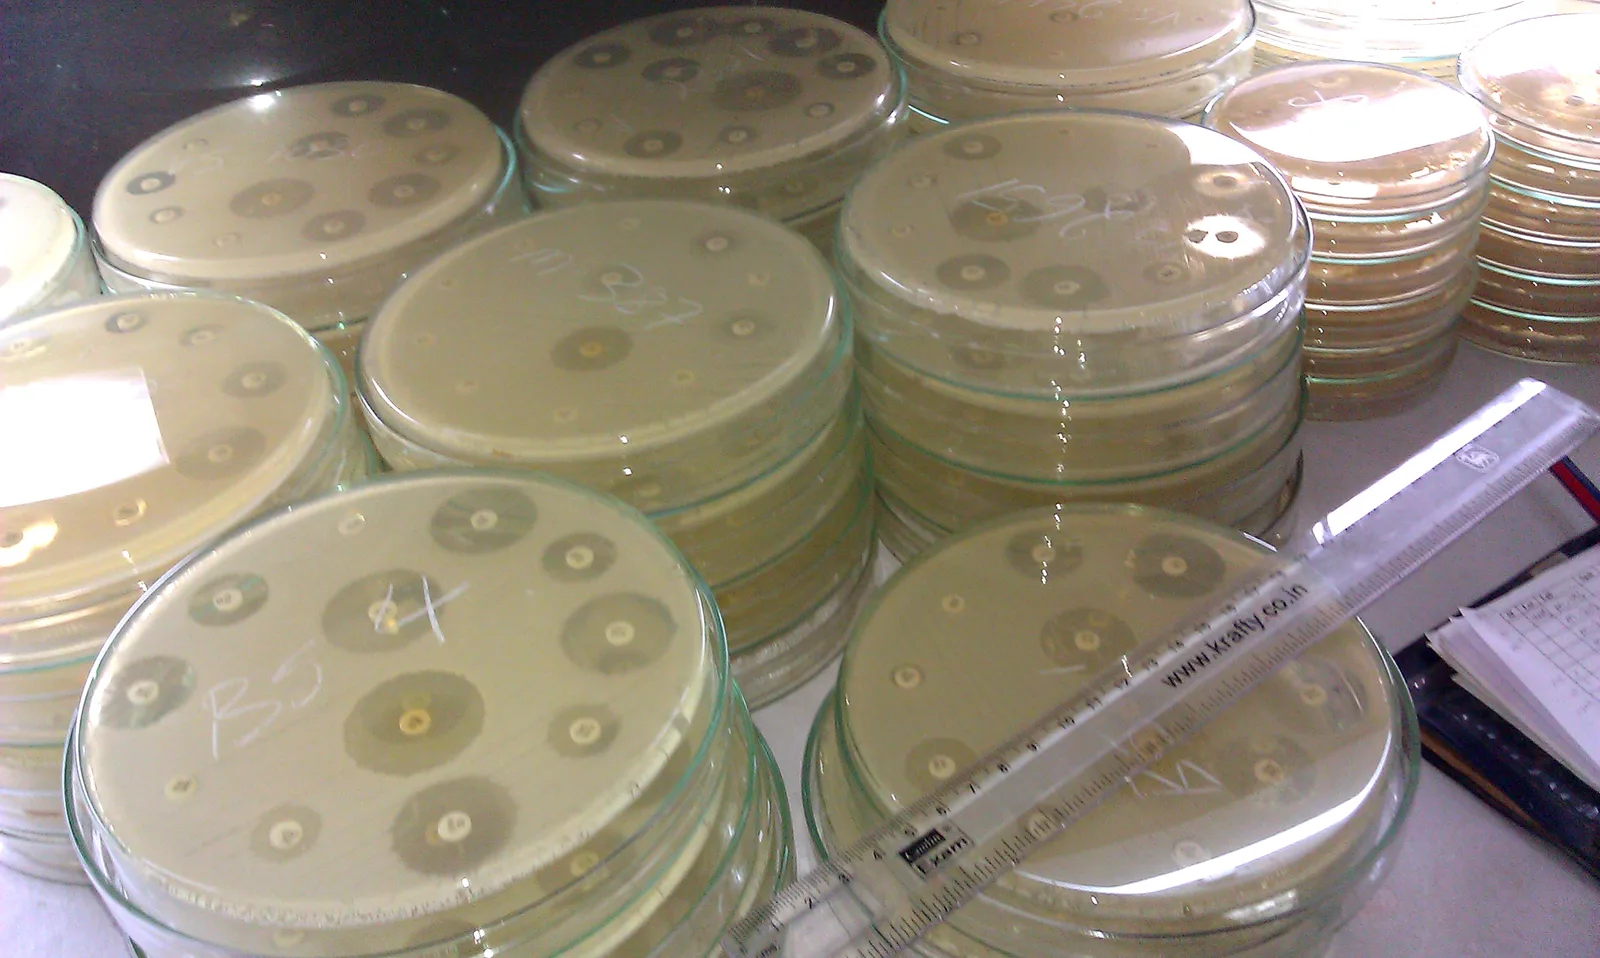
항생제 감수성 디스크 확산 검사(Kirby-Bauer 방식) 배양접시 — 이 논문에서 직접 쓰인 실험 사진은 아니고, 항생제 후보 물질이 병원균 증식을 억제하는지 실제로 확인하는 대표적인 실험 방식을 보여주는 참고 이미지입니다. 출처: Microrao, Wikimedia Commons, CC BY-SA 4.0 — 원본 보기

왜 이 주제가 세특 소재로 좋은가
생물의 유전 교과서의 생명공학기술 단원에서 배우는 유전체 분석·염기서열 데이터 활용을 실제 신약 개발 사례로 확장해서 보여주는 소재예요. 특히 기계학습이 생명과학 데이터를 다루는 방식(방대한 서열 데이터에서 패턴을 찾아 후보를 좁히는 과정)을 구체적으로 설명할 수 있어서 융합적 사고력을 드러내기 좋고, 항생제 내성이라는 공중보건 이슈와도 자연스럽게 연결돼요. 다만 "AI가 신약을 완성했다"는 식으로 과장하지 않고 아직 초기 검증 단계라는 한계까지 짚는다면 균형 잡힌 탐구라는 인상을 줄 수 있어요.
탐구 방향성 제안
- 문헌조사 방향: 항균 펩타이드가 기존 항생제와 작용 기전(세포막 파괴 vs 특정 단백질 표적)에서 어떻게 다른지, 그래서 세균이 내성을 획득하기가 왜 더 어려운지를 조사해보세요.
- 자료 정리 아이디어: "전통적 항생제 후보 발굴(배양·분리 중심)"과 "AI 기반 유전체 마이닝(이번 연구 방식)"을 소요 기간·필요 데이터·검증 단계 기준으로 비교표를 만들어보면 발표 자료로 유용해요.
- 결과 해석 시 유의할 점: 후보 100개 중 63개가 효과를 보였다는 건 실험실 초기 단계(in vitro) 결과이고, 사람 대상 임상까지는 훨씬 더 많은 단계가 남아있다는 점을 반드시 함께 언급해야 해요.
세특 기록에 이렇게 녹일 수 있어요
실제 세특은 선생님이 학생의 활동을 관찰하고 기록하는 글이라, 자기소개서처럼 1인칭으로 쓰지 않습니다. 아래는 탐구 활동을 어떤 흐름으로 정리하면 좋을지 참고하기 위한 예시예요.
활동 계기: 항생제 내성균 증가와 신규 항생제 개발 정체라는 문제를 접하고, AI가 신약 후보 발굴에 어떻게 쓰이는지 궁금해 관련 연구를 자발적으로 조사함.
탐구 내용: 미생물 유전체·환경 메타유전체를 기계학습으로 분석해 항균 펩타이드 후보를 대규모로 발굴한 de la Fuente 팀(2024)의 연구를 조사하고, 항균 펩타이드의 작용 기전과 기존 항생제 개발 방식과의 차이를 비교해 정리함.
드러난 역량: 대용량 생물학 데이터를 다루는 AI 기술의 원리를 이해하고 이를 실제 신약 개발 문제와 연결하는 융합적 사고력을 보였으며, 연구 결과의 한계(초기 검증 단계)를 스스로 짚어내는 비판적 태도를 드러냄.
후속 연계: (생명공학, 제약, 데이터과학 등 진로 방향에 맞춰) 신약 개발 파이프라인, 항생제 내성 메커니즘, 생물정보학 등 후속 개념 탐구로 확장 가능.
위 문장은 강조하면 좋을 포인트를 잡기 위한 예시일 뿐이에요. 실제 세특 문장은 선생님이 수업·발표 중 관찰한 내용을 바탕으로 작성합니다.
더 깊이 들어가기
- 선천면역과 후천면역의 차이 — 항균 펩타이드가 선천면역계에서 어떤 역할을 하는지
- AI가 생명과학 데이터를 다루는 다른 사례들(단백질 구조 예측, 유전자 발현 패턴 분석 등)과 이번 연구의 공통점
- 신약 후보 물질이 실험실 발견에서 실제 처방 가능한 약이 되기까지 거치는 임상시험 단계(전임상 → 1상 → 2상 → 3상)
틀린 내용이나 더 궁금한 점이 있으면 문의하기로 알려 주세요. 확인한 뒤 고치고, 고친 날짜를 위에 남깁니다.
함께 보면 좋은 글
이 개념과 이어지는 글이에요.