
서열은 다 읽었는데 뜻을 모른다 — 생물정보학이 유전체를 해독하는 법
송준호(송쌤)송쌤생명과학입시연구소 대표
수업에서 이렇게 물어봅니다. "사람 유전체 30억 염기쌍을 다 읽었으면, 이제 사람에 대해 다 아는 건가요?" 대부분 고개를 갸웃합니다. 그럼 비유를 하나 듭니다. 여러분이 한 번도 배운 적 없는 외국어로 쓰인 책 한 권을 받았습니다. 글자는 전부 또박또박 옮겨 적을 수 있어요. 그런데 어디서 문장이 시작하고 끝나는지, 그 문장이 무슨 뜻인지는 모릅니다.
개념 20.1에서 본 것이 딱 그 상태입니다. 읽는 건 끝났습니다. 이제 뜻을 붙이는 일이 남았고, 그 일을 하는 분야가 생물정보학(bioinformatics)입니다.
유전자 주석 — 서열 위에 표시를 다는 일
ACGT가 끝없이 이어진 문자열에서 "여기부터 여기까지가 유전자다"라고 표시하는 작업을 유전자 주석(gene annotation)이라고 합니다. 사람이 눈으로 할 수 있는 규모가 아니죠. 30억 글자니까요. 그래서 컴퓨터에게 세 가지 단서를 주고 찾게 합니다.
첫 번째 단서는 ORF(open reading frame, 해독틀)입니다. 유전암호를 배울 때 개시코돈 AUG로 시작해 종결코돈에서 끝난다고 했죠. 그 규칙을 거꾸로 씁니다. 서열에서 개시코돈을 찾고, 같은 틀로 코돈을 세어 나가다가 종결코돈이 나올 때까지의 구간을 잘라내는 거예요. 이 구간이 충분히 길면 단백질을 지정하는 유전자일 가능성이 높습니다.
다만 여기서 학생들이 자주 오해합니다. ORF를 찾았다고 유전자를 찾은 건 아닙니다. 무작위 서열에서도 짧은 ORF는 얼마든지 우연히 생기고, 진핵생물은 유전자 중간에 인트론이 끼어들어 ORF가 뚝뚝 끊깁니다. 세균 유전체라면 ORF 탐색만으로도 꽤 정확하지만, 사람 유전체에서는 이것만으로는 어림도 없어요.
두 번째 단서 — 이미 아는 서열과 비교한다
그래서 두 번째 단서가 훨씬 강력합니다. 이미 기능이 밝혀진 서열과 닮았는지 확인하는 것이죠. 진화적으로 같은 조상에서 갈라져 나온 유전자는 서열이 비슷하게 남아 있으니, 초파리에서 기능을 아는 유전자와 닮은 구간이 사람 유전체에 있다면 그 구간도 비슷한 일을 할 거라고 추정할 수 있습니다.
두 서열을 나란히 놓고 어느 위치가 맞는지 맞춰보는 작업을 서열 정렬(sequence alignment)이라고 합니다. 문제는 데이터베이스의 수억 개 서열과 하나하나 정렬하면 시간이 감당이 안 된다는 것. 그래서 나온 것이 BLAST입니다. 통째로 맞춰보는 대신 짧은 조각이 일치하는 지점을 먼저 빠르게 찾고, 그 주변으로만 정렬을 확장하는 방식이에요. 덕분에 서열 하나를 넣으면 몇 초 만에 "이것과 닮은 서열이 어느 생물의 어느 유전자에 있다"는 목록이 돌아옵니다.
세 번째 단서 — 실제로 발현되는지 확인한다
아예 세포에서 만들어진 RNA를 뽑아 서열을 읽고 유전체에 되맞춰 보는 방법도 씁니다. 그 RNA가 실제로 있었다는 건 그 구간이 진짜 전사된다는 직접 증거죠. 게다가 인트론이 제거된 성숙한 mRNA를 유전체에 맞추면 엑손과 인트론의 경계까지 그대로 드러납니다. 발현 분석 기술에서 배운 방법들이 여기서 주석의 증거로 쓰이는 겁니다.
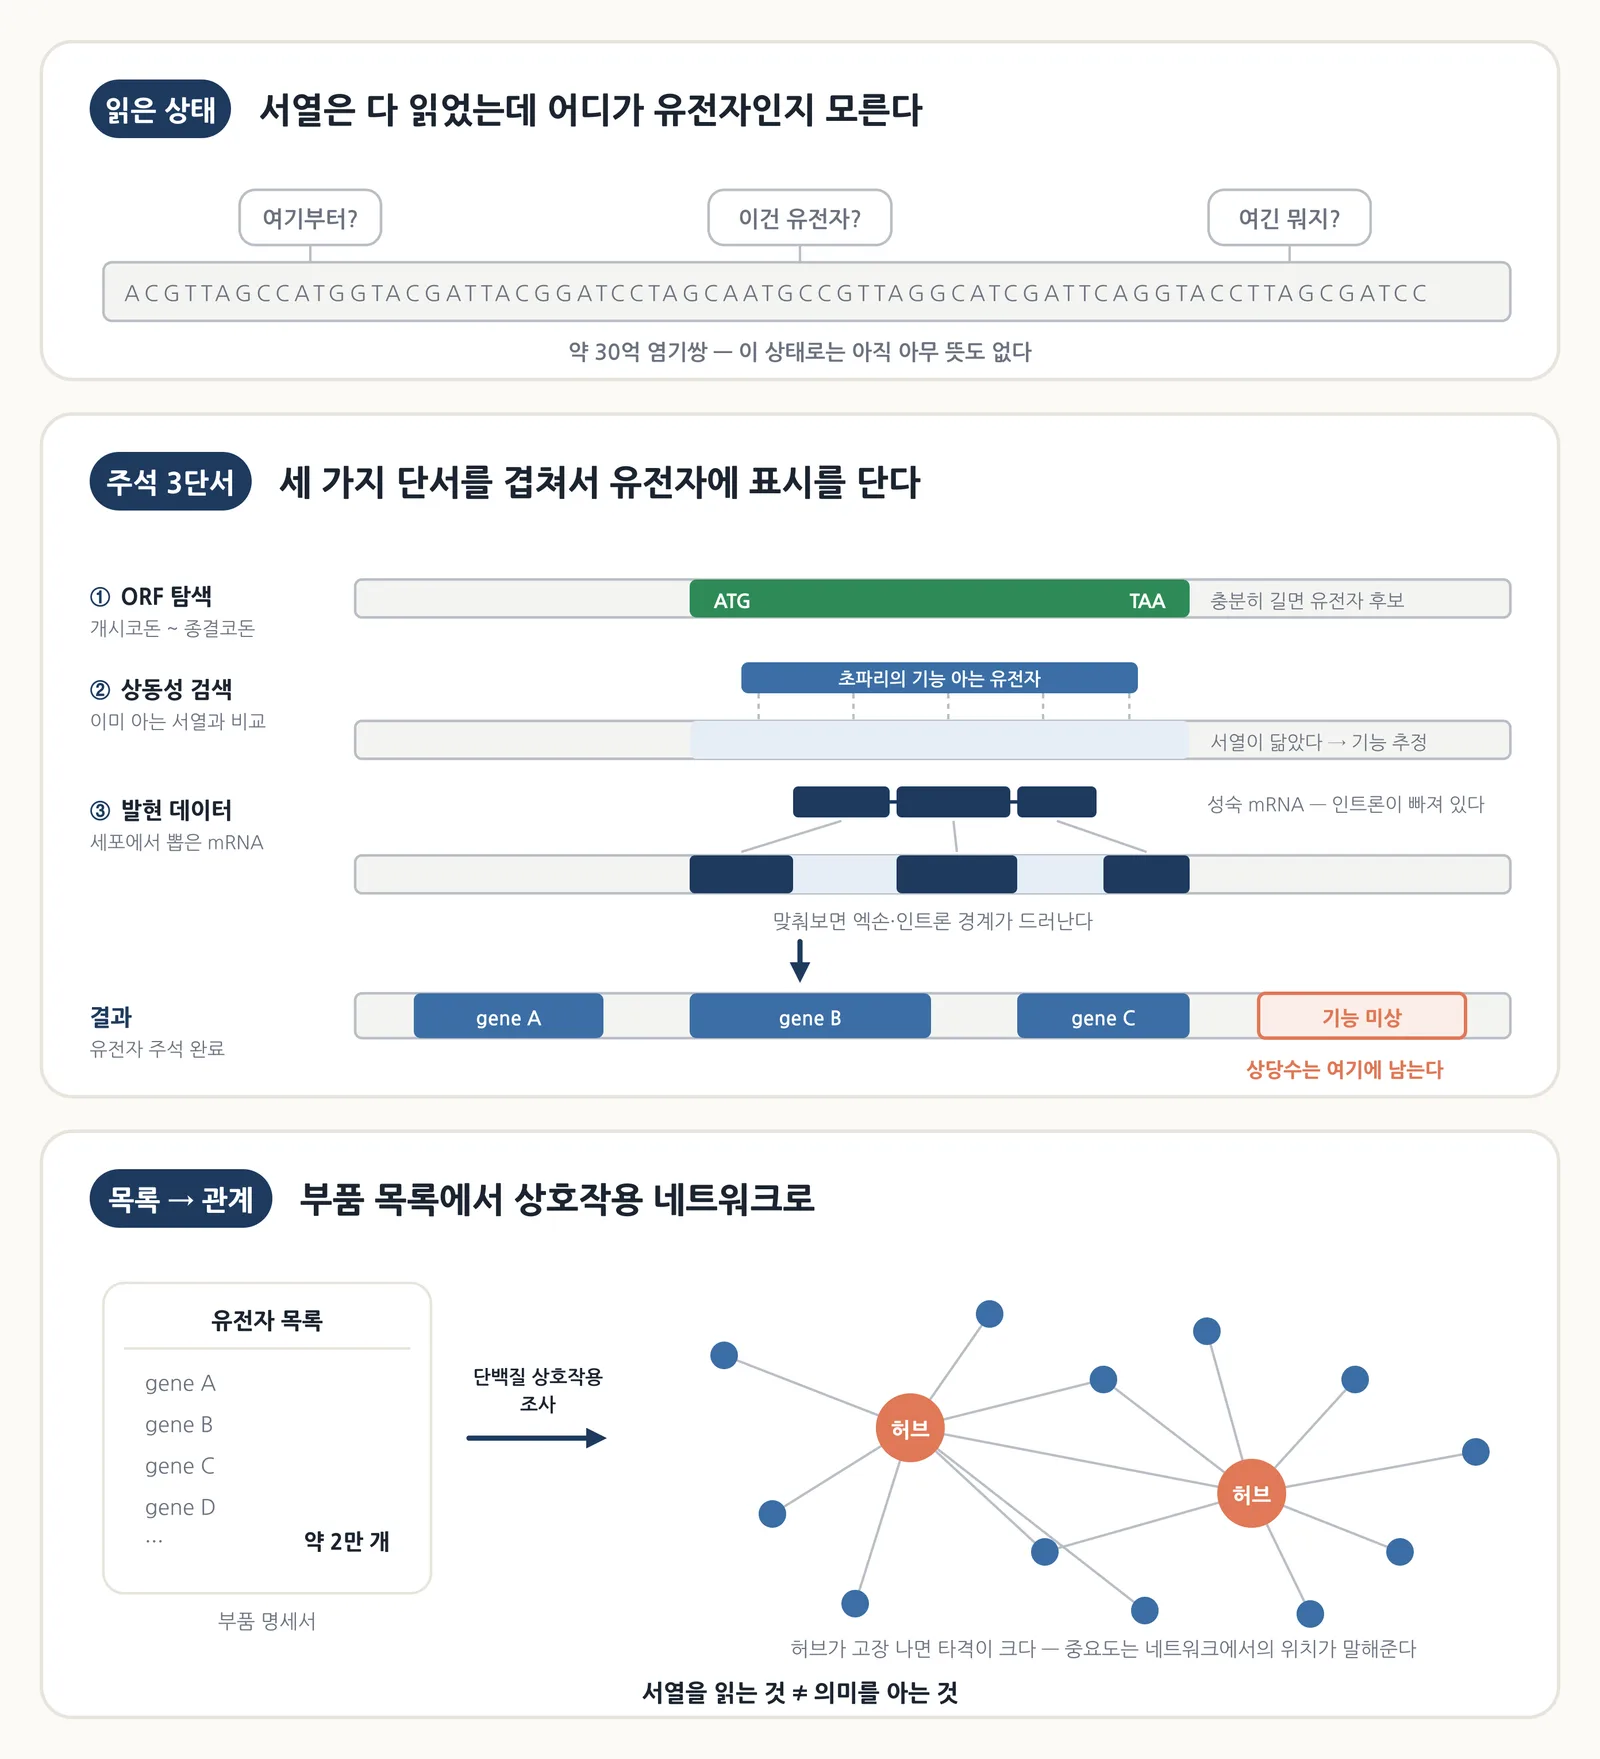
읽은 서열에 뜻을 붙이고, 목록을 네트워크로 확장하기까지 — 송쌤생명과학 자체 제작
공개 데이터베이스 — 모두가 같은 서랍을 쓴다
이 모든 작업이 가능한 건 서열이 공개돼 있기 때문입니다. 미국 NCBI의 GenBank, 유럽의 ENA, 일본의 DDBJ가 매일 데이터를 주고받으며 사실상 하나의 데이터베이스로 운영돼요. 전 세계 어느 연구실에서 서열을 등록하든 다음 날이면 셋 모두에서 검색됩니다. 논문을 내려면 서열을 먼저 등록하는 것이 관행이고요.
Ensembl이나 UCSC 게놈 브라우저 같은 도구도 함께 발달했습니다. 염색체 위 한 구간을 지도처럼 확대해 어떤 유전자가 있고 어디가 엑손인지를 층층이 겹쳐 볼 수 있어요. 이 자원이 전부 무료라는 점이 이 분야가 빨리 큰 이유 중 하나입니다.
쌤 한마디 — 유전체를 다 읽고 나서 연구자들이 가장 당황한 지점이 뭔지 아세요? "유전자 목록은 얻었는데 상당수가 기능을 모른다"는 것이었습니다. 이게 왜 생기냐면, 주석의 가장 강력한 단서가 이미 아는 서열과의 비교이기 때문이에요. 비교 대상 자체가 없는 유전자는 닮은 것을 찾을 수 없으니 "단백질을 만드는 것 같긴 한데 무슨 일을 하는지는 모르겠다"로 남습니다. 서열 읽기는 기계가 몇 시간에 끝내지만, 기능 확인은 실험으로 하나씩 해야 하니 속도가 비교가 안 되죠. 이 간극이 지금도 안 메워졌습니다.
시스템 생물학 — 목록에서 관계로
그런데 기능을 하나씩 밝힌다고 해도 끝이 아닙니다. 부품 목록을 다 안다고 기계가 어떻게 돌아가는지 아는 건 아니니까요. 그래서 관점이 한 단계 올라갑니다. 개별 유전자가 아니라 구성 요소들이 이루는 관계 전체를 하나의 계(system)로 보는 것, 이것이 시스템 생물학입니다.
| 접근 | 대상 | 묻는 질문 |
|---|---|---|
| 유전체학 | 한 생물의 유전자 전체 | 유전자가 몇 개이고 어디에 있나 |
| 프로테오믹스 | 세포가 만드는 단백질 전체 | 지금 어떤 단백질이 얼마나 있나 |
| 시스템 생물학 | 요소들 사이의 상호작용 전체 | 이들이 어떻게 맞물려 돌아가나 |
프로테오믹스(proteomics)를 따로 보는 이유가 있습니다. 유전자 목록은 고정돼 있지만 단백질 구성은 세포마다, 시점마다 달라지거든요. 같은 유전체를 가진 간세포와 신경세포가 전혀 다른 단백질 조합을 갖는 것처럼요. 유전체만으로는 세포의 상태를 설명할 수 없습니다.
단백질들이 서로 결합하는 관계를 모두 조사해 점과 선으로 그린 것이 단백질 상호작용 네트워크입니다. 이걸 그려보면 흥미로운 구조가 보여요. 연결선이 몇 개뿐인 단백질이 대다수인 반면, 수십 개와 연결된 소수의 허브가 존재합니다. 그리고 허브가 고장 났을 때 세포가 받는 타격이 훨씬 큽니다. 유전자 하나의 중요도를 서열이 아니라 네트워크에서의 위치로 판단할 수 있게 된 셈이죠.
정리하면
서열을 읽는 것과 의미를 아는 것은 전혀 다른 일입니다. 생물정보학은 그 사이를 메우는 분야이고, 유전자 주석은 ORF 탐색·상동성 검색·발현 데이터라는 세 단서를 겹쳐서 진행됩니다. 어느 하나만으로는 부족하기 때문에 겹치는 거예요. 그렇게 얻은 목록도 결국 부품 명세서일 뿐이라, 다음 단계는 그 부품들의 관계를 보는 시스템 생물학으로 이어집니다.
자, 그럼 그렇게 읽어낸 유전체들을 종끼리 늘어놓고 비교하면 무엇이 보일까요? 유전체가 클수록 복잡한 생물일 것 같지만, 실제 숫자는 그 예상을 정면으로 배신합니다. 다음 개념 20.3에서 그 표를 직접 보겠습니다.
틀린 내용이나 더 궁금한 점이 있으면 문의하기로 알려 주세요. 확인한 뒤 고치고, 고친 날짜를 위에 남깁니다.
함께 보면 좋은 글
이 개념과 이어지는 글이에요.