
양파가 사람보다 유전체가 크다 — 유전체 크기·유전자 수·밀도의 종간 차이
송준호(송쌤)송쌤생명과학입시연구소 대표
칠판에 두 가지를 적어놓고 학생들에게 고르라고 합니다. "사람과 양파, 어느 쪽 유전체가 더 클까요?" 당연히 사람이라는 답이 압도적으로 나옵니다. 그런데 답은 양파예요. 그것도 조금 큰 게 아니라 다섯 배쯤 큽니다.
이 결과가 농담처럼 들리겠지만, 여기에 유전체학의 중요한 교훈이 들어 있습니다. 여러 종의 유전체를 나란히 놓고 비교할 때는 크기, 유전자 수, 유전자 밀도 이 세 가지를 따로 봐야 하고, 셋은 서로 비례하지 않습니다.
숫자부터 확인합시다
먼저 대표적인 종들의 값을 봅시다. 모두 대략적인 값이라는 점을 꼭 기억하세요. 주석 기준이 개정될 때마다 유전자 수는 조금씩 바뀝니다.
| 생물 | 유전체 크기(염기쌍) | 유전자 수(대략) | 유전자 밀도(Mb당) |
|---|---|---|---|
| 대장균(세균) | 약 460만 | 약 4,300 | 약 900 |
| 효모 | 약 1,200만 | 약 6,000 | 약 500 |
| 예쁜꼬마선충 | 약 1억 | 약 20,000 | 약 200 |
| 초파리 | 약 1억 7천만 | 약 14,000 | 약 80 |
| 애기장대(식물) | 약 1억 2천만 | 약 27,000 | 약 200 |
| 사람 | 약 30억 | 약 20,000 | 약 7 |
표를 위에서 아래로 훑으면 경향이 하나 보입니다. 크기는 뚜렷하게 커지는데 유전자 수는 그만큼 늘지 않습니다. 대장균에서 사람까지 크기는 600배 넘게 뛰지만 유전자 수는 5배 남짓이에요. 그래서 마지막 열, 유전자 밀도가 100배 넘게 떨어집니다.
C값 역설 — 크기와 복잡성은 따로 논다
진핵생물끼리만 비교하면 경향은 아예 무너집니다. 양파의 유전체는 사람의 약 5배, 어떤 백합과 식물과 폐어는 사람의 40배를 넘습니다. 폐어를 사람보다 40배 복잡한 동물이라고 할 수는 없겠죠.
한 생물의 반수체 유전체에 든 DNA 양을 C값이라고 부르는데, 이 C값이 생물의 복잡성과 맞아떨어지지 않는 현상을 C값 역설(C-value paradox)이라고 합니다.
사실 '역설'이라는 이름은 지금 보면 과한 면이 있어요. 유전체가 전부 유전자로만 채워져 있다고 가정하면 역설이지만, 유전체의 대부분이 단백질을 지정하지 않는 DNA라면 전혀 이상할 게 없습니다. 사람 유전체에서 단백질을 지정하는 부분은 약 1.5%에 불과합니다. 나머지 98% 남짓이 얼마나 불어나 있느냐가 유전체 크기를 좌우하니, 크기가 복잡성을 따라갈 이유가 없는 거죠.
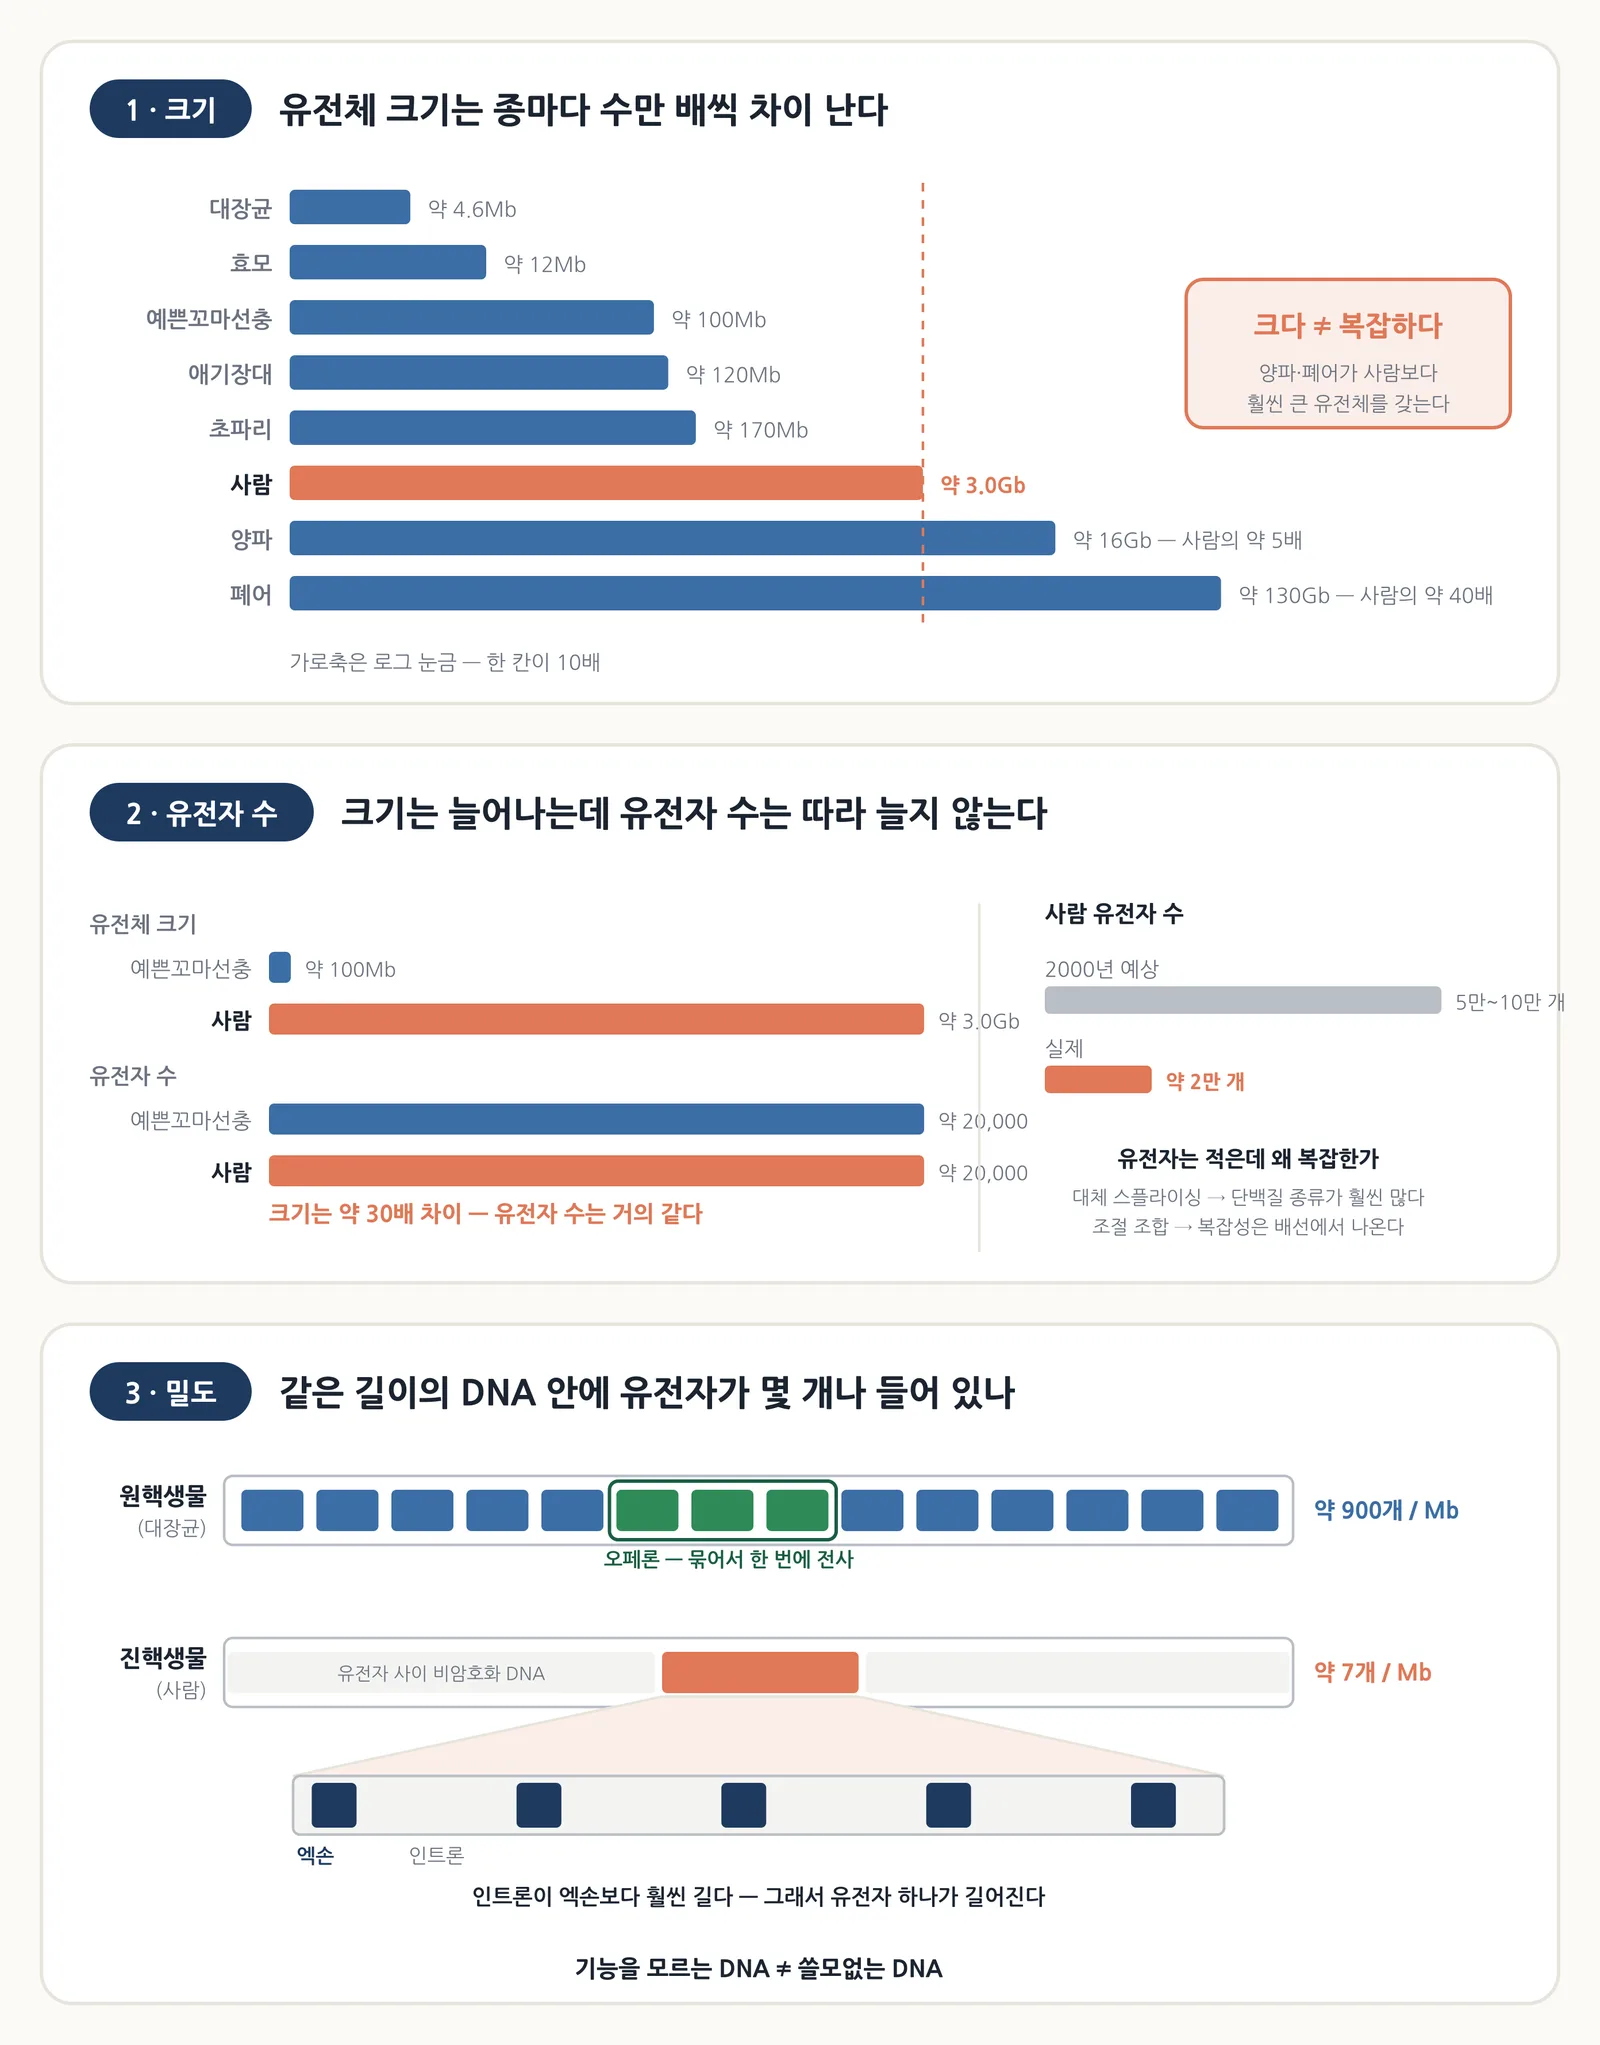
크기·유전자 수·밀도가 서로 따로 논다는 것을 한눈에 — 송쌤생명과학 자체 제작
사람 유전자가 2만 개밖에 안 된다고?
유전체 프로젝트가 진행되던 시절, 사람의 유전자 수는 5만~10만 개로 예상됐습니다. 그런데 뚜껑을 열어보니 약 2만 개였어요. 예쁜꼬마선충과 비슷한 수준입니다. 세포 1,000개 남짓한 선충과 사람의 유전자 수가 엇비슷하다는 결과는 당시로선 상당한 충격이었습니다.
이 충격은 두 가지로 해소됩니다.
첫째, 유전자 하나가 단백질 하나를 만드는 게 아닙니다. 대체 스플라이싱을 배웠죠. 엑손을 어떻게 골라 붙이느냐에 따라 같은 유전자에서 여러 종류의 폴리펩타이드가 나옵니다. 사람에서는 엑손이 여러 개인 유전자 대부분이 대체 스플라이싱을 거치는 것으로 알려져 있어요. 그래서 유전자는 2만 개라도 만들어지는 단백질의 종류는 그보다 훨씬 많습니다. 여기에 번역 후 변형까지 더해지면 차이는 더 벌어집니다.
둘째, 조절의 복잡성이 유전자 수와 별개입니다. 같은 부품이라도 언제 어디서 얼마나 켜느냐의 조합은 거의 무한합니다. 진핵생물의 다단계 조절에서 봤듯이 사람의 유전자에는 멀리 떨어진 인핸서가 여러 개 붙고, 전사인자 조합에 따라 발현 양상이 달라져요. 복잡성은 부품 개수가 아니라 배선의 복잡성에서 나옵니다.
쌤 한마디 — 2000년에 연구자들끼리 사람 유전자 수를 맞히는 내기가 벌어진 적이 있습니다. 판돈을 걸고 예상치를 적어 냈는데, 대부분이 5만 개 이상을 적었어요. 2003년에 정산했더니 가장 낮게 적어 낸 사람이 우승했고, 그마저도 실제보다 높았습니다. 시험에서 이 부분을 물으면 "왜 예상보다 적었나"를 묻는 게 아니라 "적은데도 왜 복잡한가"를 묻습니다. 답은 대체 스플라이싱과 조절, 두 축입니다.
진핵생물의 유전자 밀도는 왜 이렇게 낮을까
이제 마지막 열로 돌아갑시다. 대장균은 1Mb에 유전자가 약 900개 들어 있는데 사람은 7개 남짓입니다. 이 차이는 두 군데에서 나옵니다.
| 구분 | 원핵생물 | 진핵생물(사람) |
|---|---|---|
| 유전자 내부 | 인트론이 거의 없음 | 인트론이 엑손보다 훨씬 김 |
| 유전자 사이 | 간격이 짧고 조절부위도 작음 | 조절서열·반복서열이 넓게 깔림 |
| 유전자 하나의 길이 | 보통 수천 염기쌍 | 평균 수만 염기쌍 |
| 결과 | 유전자가 빽빽하게 붙어 있음 | 유전자가 드문드문 흩어져 있음 |
첫째는 유전자 안쪽입니다. 진핵생물 유전자는 인트론 때문에 부풀어 있어요. 근육디스트로핀 유전자는 유전체 위에서 240만 염기쌍을 차지하지만, 스플라이싱이 끝난 mRNA는 그 1%에도 못 미치고 나머지는 전부 인트론입니다. 세균 유전자는 인트론이 거의 없어 유전자 길이가 곧 암호화 길이죠.
둘째는 유전자 사이입니다. 진핵생물에서는 유전자와 유전자 사이에 조절서열과 반복서열이 넓게 깔려 있어요. 반면 원핵생물은 세포가 작고 분열이 빠른 만큼 유전체를 낭비 없이 쓰는 쪽으로 다듬어져, 오페론처럼 관련 유전자를 붙여 한꺼번에 전사하는 구조까지 갖췄습니다.
여기서도 오개념을 하나 잡고 갑시다. 단백질을 지정하지 않는 DNA를 흔히 '쓸모없는 DNA'라고 부르던 시절이 있었는데, 그 표현은 이제 쓰지 않습니다. 그 안에 조절서열이 있고, 비번역 RNA로 전사되는 구간도 있습니다. 기능을 모른다는 것과 기능이 없다는 것은 다른 얘기예요.
정리하면
유전체 크기, 유전자 수, 유전자 밀도는 서로 독립적인 지표입니다. 크기는 진핵생물 안에서도 수십 배씩 차이 나지만 유전자 수는 그만큼 벌어지지 않고, 그래서 밀도는 진핵생물로 갈수록 급격히 낮아집니다. 사람의 유전자 수가 2만 개 남짓인데도 복잡한 개체를 만들 수 있는 이유는 대체 스플라이싱과 조절의 조합이고요.
그렇다면 남은 질문은 자연스럽습니다. 진핵생물의 유전체를 이렇게까지 부풀려 놓은 비암호화 DNA는 대체 무엇으로 채워져 있을까요? 다음 개념에서 그 안을 열어보겠습니다. 반복서열과 전이인자가 주인공으로 나옵니다.
틀린 내용이나 더 궁금한 점이 있으면 문의하기로 알려 주세요. 확인한 뒤 고치고, 고친 날짜를 위에 남깁니다.
함께 보면 좋은 글
이 개념과 이어지는 글이에요.