
30억 글자를 다 읽고 나서 알게 된 것 — 사람 유전체 사업과 염기서열 기술의 발전
송준호(송쌤)송쌤생명과학입시연구소 대표
수업에서 이 질문을 자주 던집니다. "사람 유전자가 몇 개일 것 같아요?" 학생들이 대충 부르는 숫자가 보통 5만, 10만입니다. 1990년대 연구자들이 예상한 숫자도 그 근처였어요. 그런데 실제로 다 읽고 세어보니 단백질을 암호화하는 유전자는 2만 개 남짓이었습니다. 초파리가 약 1만 4천 개라는 걸 생각하면 꽤 충격적인 결과였죠.
이번 글은 그 30억 글자를 어떻게 읽었고, 읽는 기술이 그 뒤로 어디까지 갔는지에 대한 이야기입니다. DNA가 유전물질이라는 게 밝혀지고 반세기 만에 사람은 자기 설계도 전체를 손에 넣었습니다.
사람 유전체 사업 — 무엇을 하겠다는 것이었나
사람 유전체 사업(Human Genome Project, HGP)은 1990년에 공식 출범해 2003년에 완료가 선언된 국제 공동 연구입니다. 미국·영국·일본·프랑스·독일·중국 등 여러 나라의 연구기관이 참여했고, 2003년이라는 마무리 시점은 이중나선 구조 발표 50주년에 맞춘 것이기도 했습니다.
목표는 세 층이었습니다.
| 단계 | 무엇을 만드나 | 해상도 |
|---|---|---|
| 유전자 연관 지도 | 염색체마다 표지(마커)들의 상대적 순서와 거리 | 거칠다 — 재조합 빈도 기준 |
| 물리 지도 | 표지 사이의 실제 염기쌍 거리, 겹치는 DNA 조각들의 배열 | 중간 |
| 염기서열 결정 | A·T·G·C를 하나하나 확정 | 염기 1개 단위 |
지도부터 만든 이유가 중요합니다. 당시 기술로 한 번에 읽을 수 있는 길이는 수백 염기 수준이었어요. 30억 염기를 읽으려면 잘게 쪼개 읽은 뒤 다시 이어 붙여야 하는데, 어디가 어디에 붙는지 알려주는 좌표가 없으면 조립이 불가능합니다. 지도는 그 좌표계였습니다.
두 가지 전략이 경쟁했다
공공 컨소시엄이 택한 방식은 계층적 산탄총 방식입니다. 유전체를 비교적 큰 조각으로 나눠 세균 인공염색체 같은 클로닝 벡터에 넣고, 이 조각들이 유전체 어디에 해당하는지 지도 위에 먼저 배치합니다. 그런 다음 각 조각만 따로 잘게 부숴 읽고 조립해요. 위치를 알고 있는 퍼즐을 한 판씩 맞추는 셈입니다.
1998년, 크레이그 벤터가 이끄는 민간 회사 셀레라가 전혀 다른 길을 들고 나왔습니다. 전장 산탄총 방식(whole-genome shotgun)입니다. 지도 단계를 건너뛰고 유전체 전체를 처음부터 잘게 부숴 닥치는 대로 읽은 뒤, 겹치는 부분을 컴퓨터로 찾아 통째로 조립하는 방법이죠. 셀레라는 이미 1995년에 이 방식으로 세균 유전체 하나를 완성해 보인 적이 있었습니다.
| 구분 | 계층적 산탄총 | 전장 산탄총 |
|---|---|---|
| 지도 작성 | 먼저 만든다 | 생략한다 |
| 조립 부담 | 조각 단위라 가볍다 | 유전체 전체를 한꺼번에 — 계산량이 크다 |
| 강점 | 반복서열이 많아도 위치가 헷갈리지 않음 | 훨씬 빠르고 싸다 |
| 약점 | 느리고 비용이 크다 | 반복서열 구간에서 오조립 위험 |
두 진영이 경쟁하다 2001년에 나란히 초안 서열을 발표했고, 2003년에 완성 선언이 나왔습니다. 결과적으로 둘 다 옳았어요. 계산 능력이 받쳐주는 오늘날에는 전장 산탄총이 표준이 됐지만, 그게 가능했던 건 잘 만들어진 참조 유전체가 이미 있기 때문입니다.
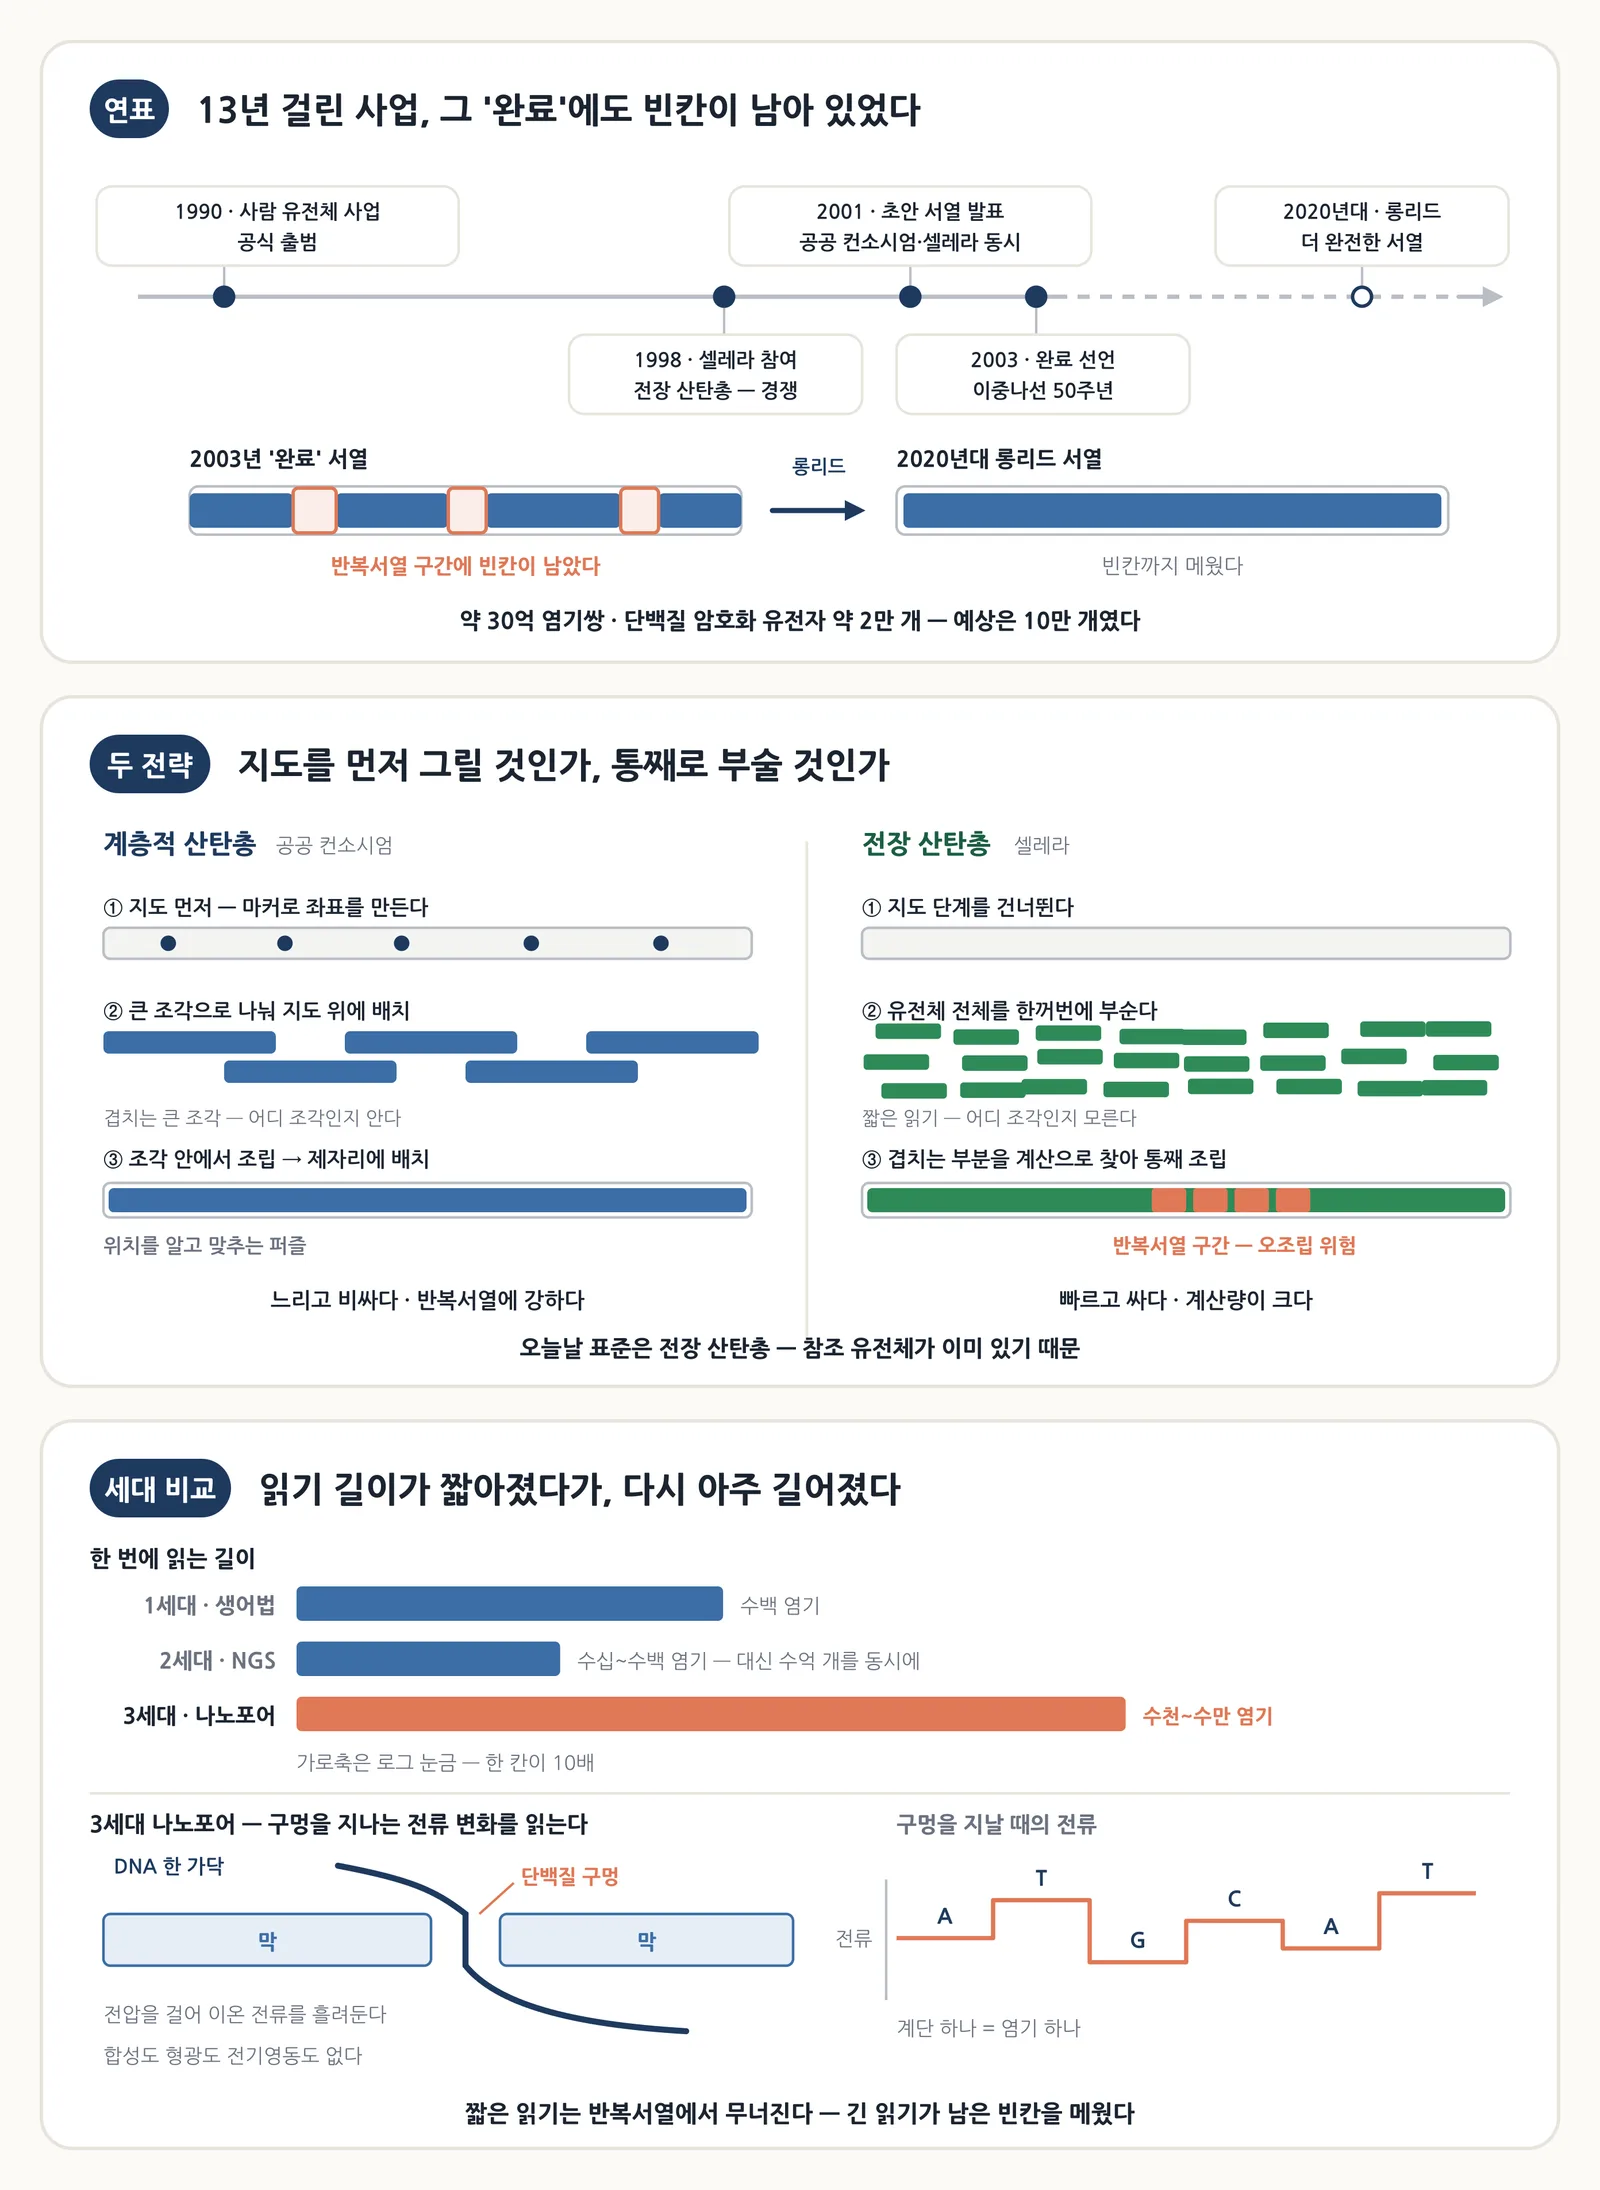
유전체를 읽어온 세 장면 — 연표, 두 조립 전략, 세대별 시퀀싱 기술 — 송쌤생명과학 자체 제작
사슬 종결법에서 대량 병렬로
HGP의 주력 도구는 생어법(다이데옥시 사슬 종결법)이었습니다. 1977년 프레더릭 생어가 고안한 방법으로, 3번 탄소에 ―OH가 없는 다이데옥시뉴클레오타이드를 섞어 넣어 합성이 그 자리에서 멈추게 만드는 원리죠. DNA 중합효소가 앞 뉴클레오타이드의 3′-OH에만 새 염기를 이어붙인다는 성질을 거꾸로 이용한 겁니다. 길이가 제각각인 산물들을 전기영동으로 줄 세우면 서열이 읽힙니다.
여기에 형광 표지와 모세관 전기영동을 붙여 자동화한 것이 HGP를 굴린 기계였고, 그래도 한 반응에서 읽히는 건 수백 염기 수준이었습니다. 30억 염기를 이 단위로 나눠 읽었으니 사업이 13년, 수십억 달러 규모가 된 거예요.
판을 바꾼 건 차세대 염기서열 분석(NGS)입니다. 핵심 발상은 반응 하나를 빠르게 하는 대신, 반응을 수억 개 동시에 돌리는 것이었어요. 아주 작은 자리마다 DNA 조각을 고정해 놓고, 염기 하나가 붙을 때마다 나오는 빛이나 신호를 카메라로 한꺼번에 찍습니다. 읽기 하나하나는 생어법보다 짧지만, 개수가 압도적이라 총 처리량이 차원이 다릅니다.
세 번째 세대 — 한 분자를 길게 읽는다
NGS에도 약점이 있습니다. 읽기가 짧다는 것. 읽기가 짧으면 반복서열 구간에서 조립이 무너집니다. 같은 서열이 여러 번 나오는 구간에서 짧은 조각들이 어디에 속하는지 알 수 없거든요. 실제로 2003년의 "완성"에도 이런 구간에는 빈칸이 남아 있었습니다.
그래서 나온 것이 단일 분자를 길게 읽는 3세대 기술입니다. 그중 나노포어 시퀀싱은 원리가 특히 아름답습니다. 막에 박힌 아주 작은 단백질 구멍에 전압을 걸어 이온 전류를 흘려놓고, 그 구멍으로 DNA 한 가닥을 통과시킵니다. 구멍을 지나는 염기의 종류에 따라 전류가 조금씩 다르게 방해받는데, 그 전류 변화 패턴을 읽어 서열을 알아냅니다. 합성도, 형광도, 전기영동도 필요 없어요. 장치가 손바닥만 하게 작아질 수 있었던 이유입니다.
긴 읽기 기술 덕분에 오래 남아 있던 빈칸들이 메워졌고, 반복서열이 빽빽한 구간까지 포함한 훨씬 완전한 사람 유전체 서열이 2020년대에 들어 발표됐습니다. HGP의 "완료"가 사실은 마침표가 아니라 쉼표였던 셈이죠.
쌤 한마디 — HGP 하나에 13년과 수십억 달러가 들었다는 숫자를 꼭 기억해 두세요. 지금은 개인 한 명의 유전체를 읽는 데 하루 남짓, 비용도 비교가 안 될 만큼 떨어졌습니다. 이 정도 속도로 싸지고 빨라진 기술은 반도체 말고는 찾기 어렵습니다. 그리고 이 변화가 앞 장에서 본 유전체 진단과 유전정보 프라이버시 문제를 한꺼번에 현실로 끌고 왔습니다. 기술이 싸지면 윤리 문제는 반드시 커집니다.
읽는 것과 이해하는 것은 다르다
여기가 이번 글에서 제일 중요한 문단입니다. 2003년에 서열이 다 나왔을 때 많은 사람이 "이제 사람을 다 알게 됐다"고 기대했어요. 실제로 벌어진 일은 달랐습니다.
사람 유전체 약 30억 염기쌍 중 단백질을 암호화하는 부분은 2% 남짓에 불과합니다. 나머지 대부분은 반복서열, 조절 부위, 단백질로 번역되지 않는 RNA의 유전자, 그리고 한동안 기능을 몰라 방치되던 구간들이에요. 번역되지 않는 RNA가 유전자 발현을 조절한다는 사실이 밝혀지면서, 이 "나머지"가 쓰레기가 아니라는 게 계속 드러나고 있습니다.
게다가 유전자 2만 개로 사람이 만들어진다는 건, 유전자 수 자체보다 대체 스플라이싱과 발현 조절이 만들어내는 조합이 훨씬 중요하다는 뜻입니다. 서열을 아는 것과 그 서열이 무슨 일을 하는지 아는 것은 완전히 다른 문제예요. 악보를 전부 베껴 적은 것과 그 곡을 이해한 것은 다릅니다.
정리하면
사람 유전체 사업은 1990년에 시작해 2003년에 완료를 선언했고, 지도를 먼저 만드는 계층적 방식과 통째로 부숴 조립하는 전장 산탄총 방식이 경쟁하며 진행됐습니다. 도구는 생어법에서 대량 병렬 NGS로, 다시 단일 분자를 길게 읽는 나노포어·롱리드 기술로 넘어왔고, 그 과정에서 비용과 시간이 극적으로 줄었습니다.
그리고 남은 문제는 읽은 것을 어떻게 이해할 것인가입니다. 수십억 글자와 수만 개의 유전자를 사람 눈으로 훑을 수는 없죠. 다음 개념(20.2)에서는 이 데이터를 다루기 위해 생겨난 분야 — 생물정보학과 유전체 비교 이야기로 넘어갑니다.
틀린 내용이나 더 궁금한 점이 있으면 문의하기로 알려 주세요. 확인한 뒤 고치고, 고친 날짜를 위에 남깁니다.
함께 보면 좋은 글
이 개념과 이어지는 글이에요.