
유전체의 98.5%는 무엇을 하고 있을까 — 비암호화 DNA와 다유전자군
송준호(송쌤)송쌤생명과학입시연구소 대표
수업을 이렇게 시작합니다. 칠판에 "사람 유전체 = 약 30억 염기쌍, 단백질 암호화 유전자 = 약 2만 개"라고 써 놓고 묻죠. "이 30억 중에서 단백질의 아미노산 서열을 실제로 지정하는 부분은 몇 퍼센트일까요?" 대부분 "절반쯤요", 적게 부르는 학생도 "10%는 되겠죠"라고 합니다.
정답은 약 1.5%입니다. 단백질 유전자의 엑손을 다 합쳐도 그 정도예요. 그러면 나머지 98.5%는 뭘까요? 이 질문이 이번 개념의 전부입니다.
유전체의 지분을 나눠 보면
기능별로 잘라 보면 대략 이렇게 갈립니다. 분류 기준이 겹쳐 수치는 자료마다 조금씩 다르니, 정확한 숫자보다 자릿수의 감각을 가져가세요.
| 구분 | 대략적 비율 | 내용 |
|---|---|---|
| 엑손(단백질·rRNA·tRNA 암호화) | 약 1.5% | 실제로 산물의 서열을 지정하는 부분 |
| 인트론과 조절 서열 | 약 20% | 유전자에 딸려 있지만 번역되지 않는 부분 |
| 고유한 비암호화 DNA | 약 15% | 반복되지 않는 정체불명 구간, 유전자 조각 등 |
| 전이인자 유래 반복 서열 | 약 44% | Alu, LINE-1 등이 남긴 흔적 |
| 그 밖의 반복 서열 | 약 14% | 단순반복서열, 큰 조각 중복 등 |
눈에 띄는 건 반복 서열이 유전체의 절반 이상을 차지한다는 점입니다. 단백질 유전자보다 훨씬 넓은 땅을 쓰고 있어요.
비암호화 DNA에도 할 일이 있다
"번역되지 않는다"와 "아무 일도 안 한다"는 전혀 다른 말입니다. 조절 서열은 프로모터·인핸서로서 어떤 유전자를 언제 켤지 결정하고, DNA가 히스톤에 감기는 방식 자체가 발현을 좌우합니다(염색체의 구조와 DNA 포장). 인트론은 스플라이싱 과정에서 잘려 나가지만, 어느 엑손을 골라 붙이느냐에 따라 유전자 하나가 여러 단백질을 만들어냅니다(전사 후 RNA 가공과 스플라이싱).
게다가 단백질로 번역되지 않는 비번역 RNA 유전자가 따로 있습니다. rRNA·tRNA는 물론이고, miRNA처럼 mRNA에 달라붙어 발현을 꺼버리는 조절용 RNA도 여기서 나옵니다(miRNA와 RNA 간섭). 최종 산물이 RNA인 유전자도 엄연히 유전자예요.
전이인자 — 자리를 옮기는 DNA
전이인자(transposable element)는 유전체 안에서 위치를 바꿀 수 있는 DNA 조각입니다. 1940년대에 바버라 매클린톡이 옥수수 낟알의 색 얼룩을 연구하다가 발견했어요. 염색체의 특정 자리가 움직인다는 주장은 당시엔 거의 받아들여지지 않았지만, 훗날 세균에서도 같은 현상이 확인되면서 정설이 됩니다.
움직이는 방식은 두 갈래입니다. 트랜스포존은 잘라내거나 복사해서 옮기고, 레트로트랜스포존은 자신을 RNA로 전사한 뒤 역전사효소로 DNA를 다시 만들어 끼워 넣습니다. 후자는 원본이 남으니 옮길 때마다 사본이 늘어나요. 반복 서열이 이렇게 불어난 주된 이유입니다.
사람의 대표 선수 둘만 기억합시다. Alu는 약 300 염기쌍짜리로 유전체의 약 10%를, LINE-1은 약 6,000 염기쌍짜리로 약 17%를 차지합니다. 다만 지금도 실제로 뛰어다닐 수 있는 건 극히 일부이고, 대다수는 돌연변이가 쌓여 멈춘 화석 상태예요.
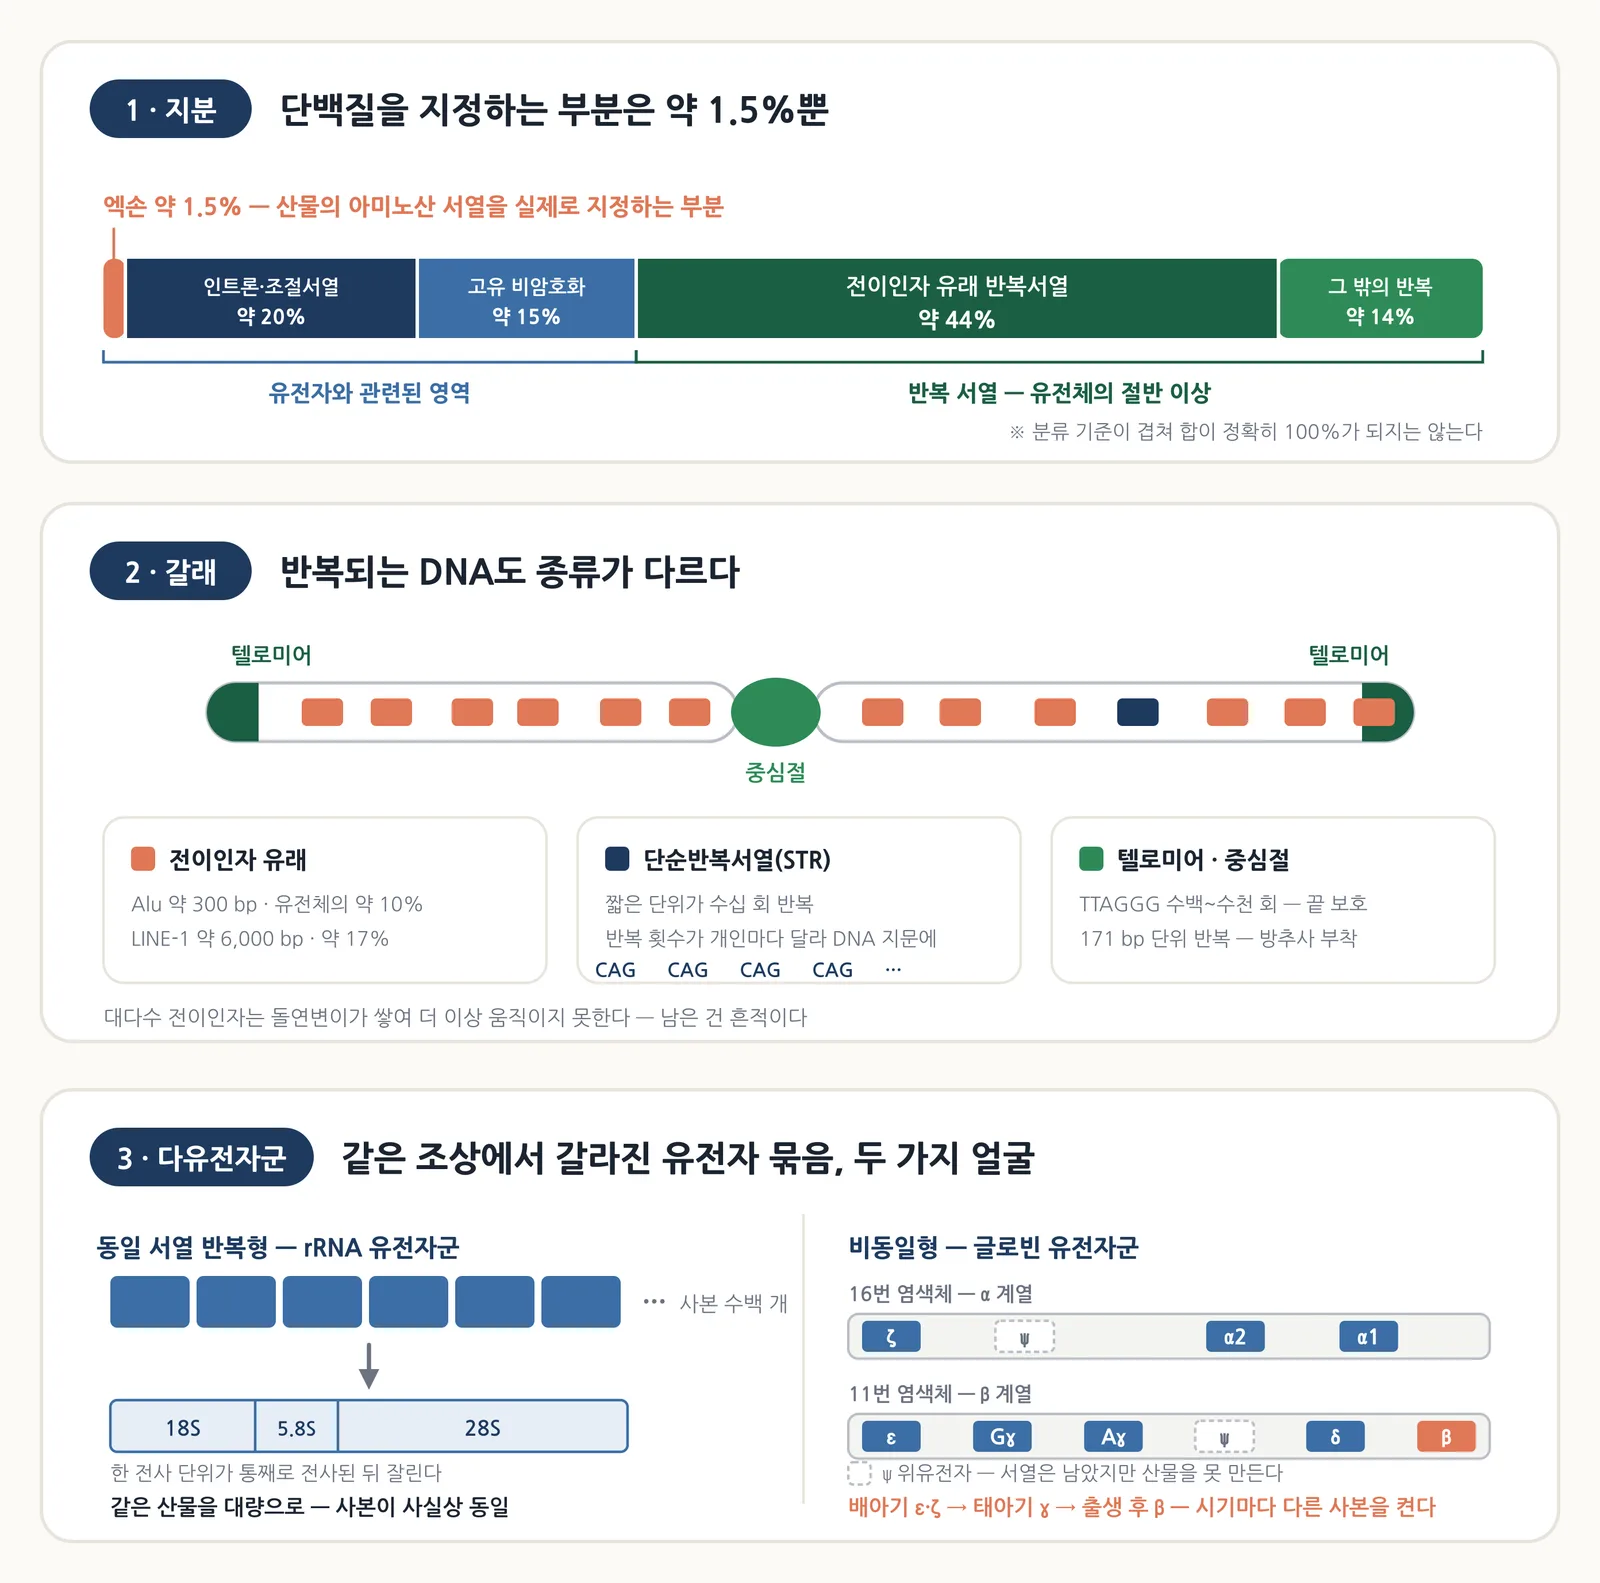
유전체의 지분 → 반복 서열의 갈래 → 다유전자군의 두 유형 — 송쌤생명과학 자체 제작
단순반복서열과 염색체의 양 끝·가운데
전이인자와 무관한 반복도 있습니다. 단순반복서열(STR)은 두세 염기짜리 짧은 단위가 수십 번 이어진 구간으로, 반복 횟수가 사람마다 달라 DNA 지문의 근거가 됩니다.
기능이 분명한 반복도 있어요. 사람의 텔로미어는 TTAGGG 여섯 염기가 수백~수천 번 반복된 구조로, 복제 때마다 짧아지는 말단을 대신 닳아 주며 염색체 끝을 보호합니다. 중심절에는 171 염기쌍 단위 반복이 대량으로 몰려 있고 여기에 방추사가 붙죠. 둘 다 단백질을 만들지 않지만 없으면 세포분열이 망가집니다.
쌤 한마디 — 바버라 매클린톡은 1983년, 여든한 살에 노벨 생리의학상을 단독 수상했습니다. 발견한 지 30년도 더 지나서였어요. 데이터는 처음부터 옳았는데 시대가 그 그림을 받아들일 준비가 안 됐던 겁니다. "유전자는 염색체 위 고정된 자리에 있다"는 상식이 워낙 견고했으니까요. 상식이 데이터를 이기는 시기가 과학에도 있다는 걸 보여주는 사례로 기억해 두세요.
다유전자군 — 한 조상에서 갈라진 유전자 묶음
다유전자군(multigene family)은 서열이 비슷해 공통 조상 유전자에서 중복되어 나온 것으로 보이는 유전자들의 집합입니다. 크게 두 유형이 있어요.
| 구분 | 동일 서열 반복형 | 비동일형 |
|---|---|---|
| 대표 예 | rRNA 유전자군 | 글로빈 유전자군 |
| 사본 사이 서열 | 사실상 동일 | 서로 조금씩 다름 |
| 배열 | 한 자리에 줄줄이 붙어 있음 | 염색체 위에 나뉘어 배치 |
| 이유 | 같은 산물을 대량으로 빠르게 | 시기·조직마다 다른 산물이 필요 |
rRNA 유전자는 리보솜을 대량으로 찍어내야 하니 사본이 수백 개씩 나란히 붙어 있고, 한 전사 단위가 통째로 전사된 뒤 잘려서 18S·5.8S·28S rRNA가 됩니다.
글로빈은 다릅니다. 헤모글로빈의 α사슬 계열은 16번 염색체에, β사슬 계열은 11번 염색체에 무리 지어 있는데, 같은 계열 안에서도 발생 시기마다 다른 사본이 켜집니다. 배아기에는 ε·ζ가, 태아기에는 γ가, 출생 후에는 β가 주로 발현돼요. 태아 헤모글로빈이 산소를 더 세게 붙잡는 덕분에 태반에서 모체 혈액으로부터 산소를 넘겨받습니다.
이 무리 안에는 위유전자(pseudogene)도 섞여 있습니다. 서열은 옆 유전자와 거의 같은데 돌연변이가 쌓여 기능하는 산물을 못 만드는 사본이에요. 망가진 채 남은 흔적이지만, 그 흔적이 오히려 유전체가 어떻게 변해왔는지를 알려주는 기록이 됩니다.
"정크 DNA"라는 말은 왜 물러났나
한때 비암호화 DNA는 통째로 junk DNA라 불렸습니다. 단백질을 안 만드니 쓰레기라는 거죠. 지금 이 표현을 조심해 쓰는 이유는 두 가지입니다.
- 조절 서열·비번역 RNA 유전자·텔로미어·중심절처럼 기능이 확인된 구간이 계속 늘어났습니다.
- 당장 기능이 없어 보이는 서열도 진화의 재료입니다. 여분 사본과 전이인자는 새 유전자가 태어나는 재료 창고 노릇을 해요.
다만 반대쪽으로도 기울지 마세요. "전사되는 흔적이 있다"가 곧 "중요한 기능이 있다"는 뜻은 아닙니다. 정확한 태도는 "쓸모없다"도 "다 쓸모있다"도 아닌 "구간마다 다르다"입니다.
정리하면
사람 유전체에서 아미노산 서열을 지정하는 부분은 약 1.5%뿐이고, 나머지는 조절 서열·인트론·비번역 RNA 유전자, 그리고 절반을 넘는 반복 서열입니다. 반복의 큰 덩어리는 전이인자가 남긴 흔적이고, 단순반복서열과 텔로미어·중심절이 나머지를 채웁니다. 다유전자군에는 rRNA처럼 동일한 사본이 줄지어 선 형태와 글로빈처럼 조금씩 다른 사본이 나뉘어 배치된 형태가 있고, 그 사이에 위유전자가 남아 있습니다.
여기까지 오면 질문이 하나 남습니다. 이 중복 사본들은 애초에 어떻게 생겨났을까요? 위유전자가 되는 사본과 새 기능을 얻는 사본은 무엇이 달랐을까요? 다음 개념(20.5)에서 유전체가 커지고 새 유전자가 태어나는 메커니즘을 다룹니다.
틀린 내용이나 더 궁금한 점이 있으면 문의하기로 알려 주세요. 확인한 뒤 고치고, 고친 날짜를 위에 남깁니다.
함께 보면 좋은 글
이 개념과 이어지는 글이에요.