
DNA를 읽고 복제하는 법 — 염기서열 분석과 DNA 클로닝
송준호(송쌤)송쌤생명과학입시연구소 대표
여기까지 오면서 우리는 세포가 DNA로 무엇을 하는지를 배웠습니다. 복제하고, 전사하고, 번역하고, 필요할 때만 켜고. 이번 장부터는 질문이 바뀝니다 — 사람이 DNA로 무엇을 할 수 있는가.
이 단원이 재미있는 이유가 하나 있어요. 여기 나오는 기술들이 전부 세포가 이미 쓰던 도구를 빌려 온 것이라는 점입니다. 사람이 새로 발명한 화학 반응이 아니라, 세균이 자기를 지키려고 만든 효소, DNA 중합효소가 원래 하던 일을 시험관으로 옮겨온 것이죠. 그래서 앞 단원들을 제대로 이해했다면 이 장은 오히려 쉽습니다.
세균의 방어 무기가 유전공학의 가위가 되다 — 제한효소
제한효소(restriction enzyme)는 DNA의 특정 짧은 서열을 알아보고 그 자리를 잘라내는 효소입니다. 원래 용도는 유전공학이 아니라 세균의 면역이었어요. 파지(세균을 감염시키는 바이러스)가 자기 DNA를 집어넣으면, 세균은 그 외래 DNA를 조각내서 무력화합니다. 이 작용이 파지의 증식을 "제한(restrict)"한다고 해서 붙은 이름이에요.
그럼 자기 DNA는 왜 안 자를까요? 세균은 자기 유전체의 그 인식 서열에 미리 메틸기를 붙여 표시해 둡니다. 메틸화된 자리는 효소가 건드리지 않아요. 아군·적군 식별 장치인 셈입니다.
제한효소가 알아보는 서열에는 재미있는 규칙이 있습니다. 대개 4~8개 염기쌍 길이인데, 위 가닥과 아래 가닥을 각각 5′→3′ 방향으로 읽으면 서열이 똑같습니다. 이런 구조를 회문(palindrome)이라고 불러요. 예를 들어 대장균에서 얻은 EcoRI는 GAATTC를 인식하는데, 반대 가닥을 5′→3′로 읽어도 GAATTC입니다. 이중나선의 상보성을 떠올리면 왜 이런 일이 가능한지 바로 보일 거예요.
더 중요한 건 자르는 방식입니다. 많은 제한효소는 두 가닥을 같은 자리에서 뚝 끊지 않고 어긋나게 자릅니다. EcoRI는 G와 A 사이를 자르는데, 위·아래 가닥에서 그렇게 하면 한 가닥만 네 염기(AATT)씩 삐져나온 끝이 생겨요. 이걸 점착말단(sticky end)이라고 합니다.
이름이 붙은 이유가 그대로 원리입니다. 같은 효소로 자른 DNA는 어디서 온 것이든 삐져나온 서열이 서로 상보적이라, 사람 DNA 조각과 세균 플라스미드가 염기쌍을 이루며 딱 맞물립니다. 종이 달라도 상관없어요. DNA는 어느 생물의 것이든 같은 언어를 쓰니까요.
쌤 한마디 — 제한효소를 발견하고 그 작동 원리를 밝힌 베르너 아버, 해밀턴 스미스, 대니얼 네이선스는 1978년 노벨 생리의학상을 받았습니다. 세 사람 다 "유전공학을 하려고" 이 연구를 시작한 게 아니었어요. 그냥 "세균은 파지를 어떻게 막아낼까"가 궁금했던 겁니다. 기초연구가 뜻밖의 도구를 낳는 전형적인 사례이고, 나중에 배울 CRISPR도 정확히 똑같은 경로(세균의 방어 시스템 → 유전자 편집 도구)를 밟았습니다.
자른 조각을 어디에 담을까 — 벡터와 재조합 DNA
조각을 잘라냈다고 끝이 아닙니다. 실험을 하려면 그 DNA가 충분히 많이 있어야 하는데, 세포 하나에서 뽑아낸 유전자 한 벌로는 아무것도 못 해요. 그래서 이 조각을 세균에게 맡겨 대신 복제시킵니다. 이것이 DNA 클로닝(cloning)입니다.
운반체 역할을 하는 게 클로닝 벡터이고, 가장 흔한 게 세균의 플라스미드 — 염색체와 별개로 존재하는 작은 원형 DNA입니다. 절차는 이렇습니다.
- 목적 유전자가 든 DNA와 플라스미드를 같은 제한효소로 자릅니다. 양쪽에 서로 맞물리는 점착말단이 생겨요.
- 둘을 섞으면 점착말단끼리 염기쌍을 이루며 붙습니다. 다만 이건 수소결합일 뿐이라 아직 끊어진 상태예요.
- DNA 리가아제가 당-인산 골격의 끊긴 자리를 이어 붙여 하나의 온전한 원형 DNA로 만듭니다. 완성된 것이 재조합 DNA입니다.
- 이 플라스미드를 대장균에 넣으면, 세균이 분열할 때마다 우리가 넣은 유전자도 함께 복제됩니다. 하룻밤이면 수십억 벌이 생겨요.
여기서 학생들이 잘 놓치는 게 있습니다. 플라스미드를 넣어준다고 모든 세균이 받아들이는 게 아니에요. 실제로는 극히 일부만 받아들입니다. 그래서 벡터에는 보통 항생제 저항 유전자가 들어 있어요. 배지에 그 항생제를 뿌리면 플라스미드를 받아들인 세균만 살아남습니다. 나머지는 알아서 걸러지는 거죠.
정리하면 쓸 만한 클로닝 벡터는 세 가지를 갖춰야 합니다 — 세균 안에서 스스로 복제되게 하는 복제원점(ori), 성공한 세균만 골라내는 선별 표지(항생제 저항 유전자), 그리고 목적 DNA를 끼워 넣을 제한효소 인식부위.
이 기술이 실제로 무엇을 바꿨는지 감이 잘 안 온다면 인슐린을 떠올려 보세요. 예전엔 당뇨 환자용 인슐린을 도축한 소·돼지의 이자에서 뽑아 썼습니다. 양이 턱없이 부족했고, 사람 것과 미세하게 달라 면역 반응 문제도 있었어요. 사람 인슐린 유전자를 세균에 넣어 만든 재조합 인슐린이 1982년에 처음 시판되면서 이 문제가 통째로 사라졌습니다. 세계 최초의 재조합 DNA 의약품입니다.
세포 없이 DNA를 늘린다 — PCR
클로닝은 강력하지만 세균을 키워야 하니 며칠이 걸립니다. 그리고 애초에 세균에 넣을 만큼의 DNA가 있어야 하죠. 범죄 현장의 머리카락 한 올, 화석 조각에서 나온 미량의 DNA라면 어떻게 할까요.
PCR(중합효소 연쇄반응)은 세포를 전혀 쓰지 않고 시험관 안에서 특정 구간만 골라 증폭합니다. 원리는 놀랍도록 단순해요 — DNA 복제에서 배운 그 과정을 온도만 바꿔가며 반복하는 겁니다.
- 변성 (약 95 ℃) — 열로 이중나선의 수소결합을 끊어 두 가닥을 떼어냅니다. 세포 안에서 헬리카아제가 하던 일을 열이 대신하는 셈이에요.
- 프라이머 결합 (약 50~65 ℃) — 온도를 낮추면 미리 넣어둔 짧은 DNA 프라이머가 목표 구간의 양 끝에 상보적으로 붙습니다.
- 신장 (약 72 ℃) — DNA 중합효소가 프라이머의 3′ 끝에서부터 새 가닥을 합성합니다.
이 세 단계가 한 사이클이고, 사이클마다 DNA 양이 두 배가 됩니다. 30회면 2를 서른 번 곱한 값 — 약 10억 배예요. 그래서 몇 시간이면 눈에 보이지도 않던 양이 실험에 쓸 만큼 늘어납니다.
여기서 두 가지를 짚고 갈게요. 첫째, 어느 구간이 증폭될지를 정하는 건 프라이머입니다. 프라이머 두 개가 붙는 자리 사이만 늘어나요. 그래서 PCR은 "DNA를 무작정 늘리는 기술"이 아니라 "내가 지정한 구간만 골라 늘리는 기술"입니다. 뒤집어 말하면 목표 구간 양 끝의 서열을 미리 알아야 프라이머를 설계할 수 있다는 한계도 함께 갖고 있습니다.
둘째, 95 ℃를 오가는데 효소가 안 익어버릴까요? 보통의 단백질이라면 진작 변성됩니다. 그래서 PCR에는 내열성 DNA 중합효소를 씁니다. 대표적인 게 옐로스톤 국립공원의 온천에 사는 호열성 세균 Thermus aquaticus에서 얻은 Taq 중합효소예요. 뜨거운 물에서 사는 미생물을 연구하던 사람들이 없었다면 PCR은 훨씬 늦게 실용화됐을 겁니다.
쌤 한마디 — PCR을 고안한 캐리 멀리스는 1983년 어느 밤 캘리포니아의 산길을 운전하다가 이 아이디어를 떠올렸다고 회고합니다. 프라이머 두 개로 구간을 지정하고 그걸 반복하면 지수적으로 늘어난다는 발상 자체는 종이 한 장이면 설명되는 단순한 것이었어요. 그는 1993년 노벨 화학상을 받습니다. 참고로 Taq 중합효소는 교정(3′→5′ 엑소뉴클레아제) 기능이 없어서 복제 오류율이 세포 안의 중합효소보다 높습니다. 정확도가 중요한 실험에서는 교정 기능이 있는 다른 내열성 중합효소를 쓰는 이유예요.
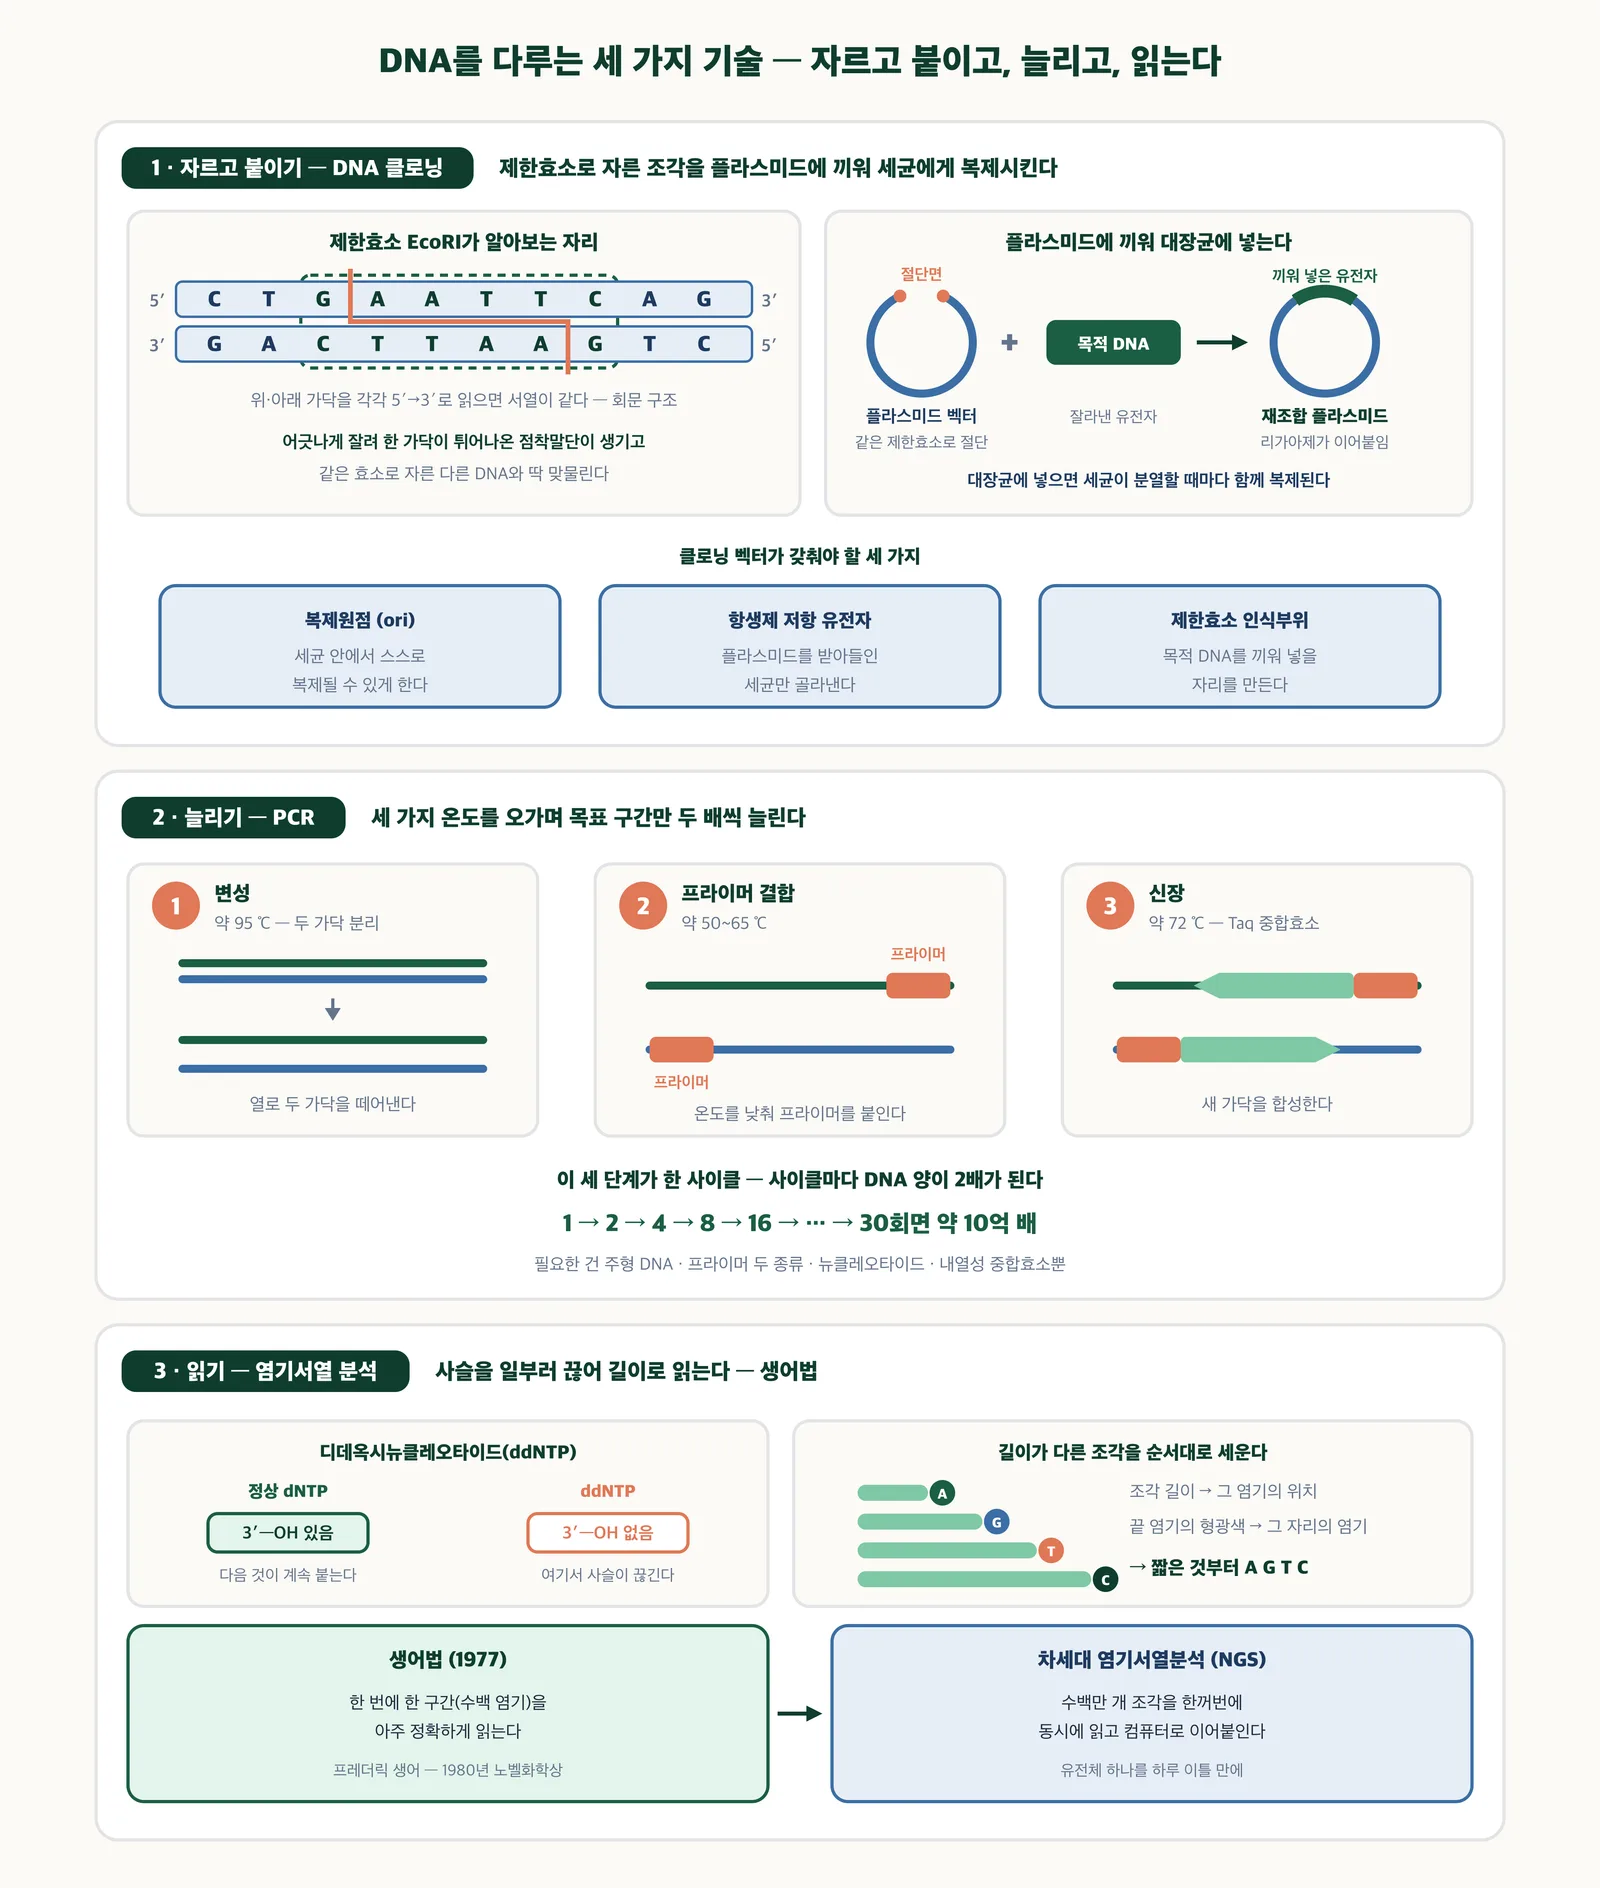
DNA를 자르고 붙이는 클로닝, 시험관에서 늘리는 PCR, 길이로 읽어내는 생어법 — 송쌤생명과학 자체 제작
사슬을 일부러 끊어서 읽는다 — 생어법
이제 마지막 질문입니다. 염기 순서를 어떻게 알아내나? 현미경으로 들여다볼 수는 없잖아요.
프레더릭 생어가 1977년에 내놓은 답은 발상이 절묘합니다. 핵심은 디데옥시뉴클레오타이드(ddNTP)라는 가짜 재료예요. 보통의 뉴클레오타이드는 당의 3′ 자리에 -OH가 있어서 다음 뉴클레오타이드가 여기에 인산다이에스터 결합으로 이어집니다. 그런데 ddNTP는 3′-OH가 없습니다. 그래서 사슬에 한 번 들어가면 그 자리에서 합성이 멈춰버려요.
여기서 요령이 나옵니다. 정상 뉴클레오타이드를 잔뜩 넣고 ddNTP를 소량만 섞어두면, 합성이 어디서 멈출지는 우연이 결정합니다. 반응을 수없이 반복하면 결과적으로 가능한 모든 길이의 조각이 조금씩 다 만들어져요. 1번 염기에서 끊긴 것, 2번에서 끊긴 것, 3번에서 끊긴 것….
그리고 네 종류의 ddNTP(A·G·C·T)에 각각 다른 색의 형광 물질을 붙여둡니다. 이제 이 조각들을 전기영동으로 길이 순서대로 세우면 됩니다. 조각의 길이가 그 염기의 위치를 알려주고, 그 조각 맨 끝의 형광색이 그 자리의 염기 종류를 알려줘요. 짧은 것부터 색을 차례로 읽으면 그게 곧 염기서열입니다.
"어디서 끊길지 모르는 무작위성"을 오히려 정보로 바꿔버린 셈이죠. 생어는 이 업적으로 1980년 노벨 화학상을 받는데, 이미 1958년에 인슐린의 아미노산 서열을 밝혀 같은 상을 한 번 받은 적이 있었습니다.
유전체 하나를 하루에 — 차세대 염기서열분석
생어법은 정확하지만 한 번에 한 구간, 길어야 수백~1천 염기 정도를 읽습니다. 사람 유전체는 30억 염기쌍이에요. 이 방식으로 인간 유전체 프로젝트는 1990년에 시작해 2003년에야 완료를 선언했습니다. 13년, 수많은 나라의 연구소가 나눠 맡아서요.
차세대 염기서열분석(NGS)은 접근을 바꿉니다. 조각 하나를 길게 읽으려 애쓰는 대신, 유전체를 잘게 부순 뒤 수백만~수십억 개 조각을 동시에 병렬로 읽고, 겹치는 부분을 컴퓨터로 맞춰 원래 순서를 복원해요. 조각 하나하나는 짧지만 개수로 밀어붙이는 전략입니다. 덕분에 13년 걸리던 일이 지금은 장비 한 대로 하루 이틀이면 끝납니다.
이게 왜 중요한지는 진료실에서 드러납니다. 원인을 알 수 없던 희귀 유전질환 환자의 유전체를 통째로 읽어 원인 변이를 찾아내는 일이 이제 현실적인 선택지가 됐어요. 가계도로 유전 양상을 추정하던 단계에서, 실제 서열을 직접 확인하는 단계로 넘어온 겁니다. 물론 서열을 읽는 것과 그게 무슨 뜻인지 해석하는 것은 전혀 다른 문제이고, 지금 생명과학의 어려운 부분은 오히려 후자 쪽으로 옮겨가 있습니다.
여기까지가 DNA를 자르고, 붙이고, 늘리고, 읽는 기본 도구들입니다. 다음 글에서는 이 도구들을 실제로 조합해서 유전자가 언제 어디서 켜지는지, 그 유전자가 무슨 일을 하는지를 알아내는 방법으로 넘어갑니다.
틀린 내용이나 더 궁금한 점이 있으면 문의하기로 알려 주세요. 확인한 뒤 고치고, 고친 날짜를 위에 남깁니다.
함께 보면 좋은 글
이 개념과 이어지는 글이에요.